รีวิวเปเปอร์ DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation
Read in English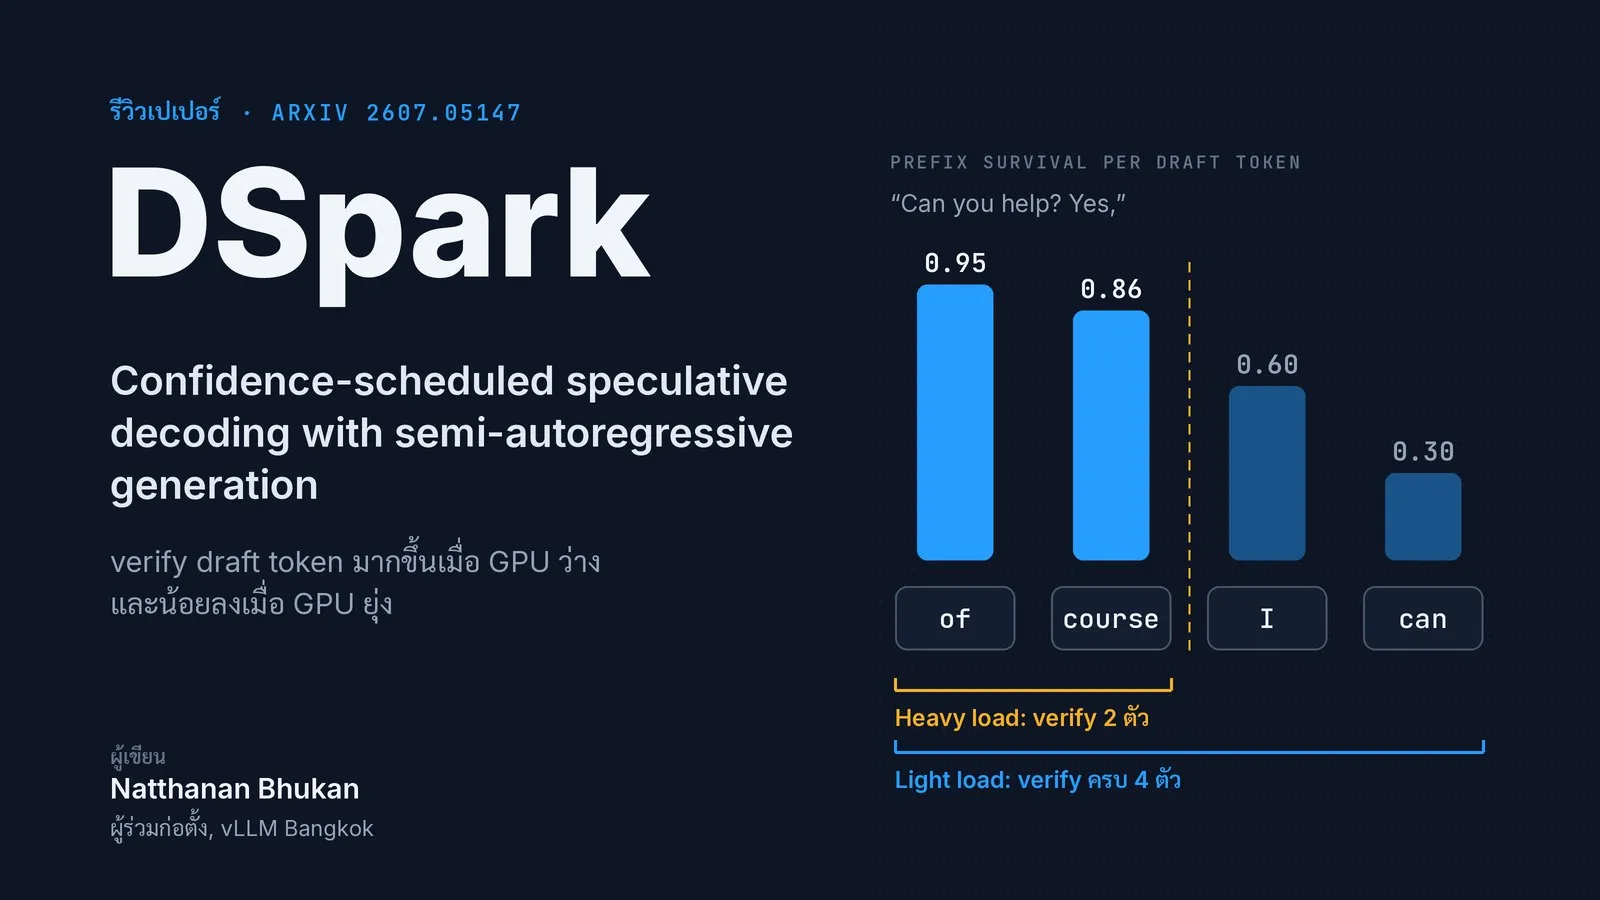
ใน speculative decoding การ verify draft token เพิ่มอีกไม่กี่ตัวอาจช่วย request หนึ่งได้ แต่ถ้าระบบอยู่ใน heavy load token เหล่านั้นจะไปแย่ง GPU capacity ที่ควรใช้ serve request อื่น DSpark (Xin Cheng และคณะ, DeepSeek-AI และ Peking University) แก้ปัญหานี้โดยประเมินว่า draft token แต่ละตัวมีโอกาสถูก accept แค่ไหน แล้วดูประกอบกับว่า GPU ยุ่งอยู่แค่ไหน ถ้า GPU ยังมี capacity เหลือก็ verify มากขึ้น ถ้าไม่เหลือก็ verify น้อยลง เพราะ token ที่เกินมาจะทำให้ทั้ง batch ช้าลง ผลคือ total throughput ของระบบยังสูงอยู่ได้
สรุปสั้น (TL;DR)
DSpark ใช้ parallel drafting backbone คู่กับ sequential Markov head ตัวเล็ก เพื่อลด suffix decay โดยไม่ต้องใช้ autoregressive drafter เต็มรูปแบบ จากนั้นใช้ token confidence ที่ calibrate แล้ว ร่วมกับ GPU step time ที่ profile ไว้ เพื่อเลือกว่าแต่ละ request ควร verify draft token กี่ตัวภายใต้ load ขณะนั้น ทีมผู้วิจัยรายงานว่า accepted length สูงขึ้นในทั้งสี่ target model และ throughput ใน production ดีขึ้นอย่างมากเมื่อเทียบกับ MTP-1
1. ทำไม decode ถึงเป็น bottleneck
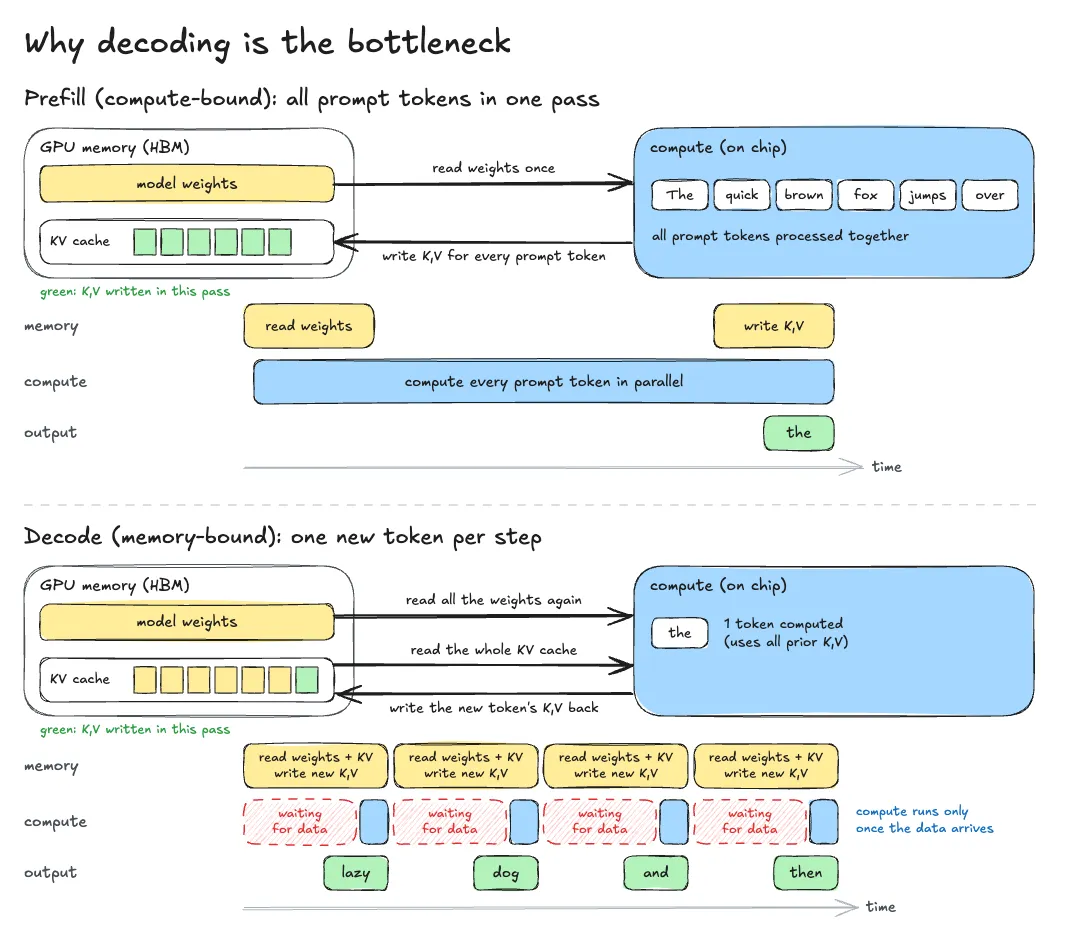
LLM inference มีสองช่วงคือ prefill และ decode ช่วง prefill (ด้านบนของภาพ) โมเดลจะประมวลผลทั้ง prompt ใน forward pass เดียว สร้าง KV cache และได้ output token ตัวแรกออกมา เนื่องจากทุก token ใน prompt ถูกประมวลผลแบบ parallel weights ที่อ่านจาก memory แต่ละครั้งจึงถูกใช้ซ้ำกับหลาย token เมื่อ prompt ยาวพอ prefill มักเป็น compute-bound คือเวลาส่วนใหญ่หมดไปกับการคำนวณ ไม่ใช่การรอข้อมูล
ช่วง decode (ด้านล่างของภาพ) จะสร้าง token ที่เหลือทีละ step จนกว่าโมเดลจะปล่อย end-of-sequence token หรือถึง max output length แต่ละ token ขึ้นกับ token ก่อนหน้า ทุก step จึงต้องอ่าน model weights และ KV cache จาก GPU memory เพื่อสร้าง token ถัดไป เมื่อ batch เล็ก ปริมาณการคำนวณต่อข้อมูลหนึ่ง byte ที่อ่านมีน้อย และ KV cache ที่ต้องอ่านก็โตตาม output ไปเรื่อยๆ GPU จึงใช้เวลาส่วนใหญ่รอข้อมูล ช่วงนี้จึงมักกินสัดส่วนใหญ่ของ end-to-end latency
ปัญหานี้แก้ได้หลายทาง เช่น prefill/decode disaggregation (ไม่ให้ prefill ที่ยาวมาขวาง decode) quantization (อ่านข้อมูลน้อยลง) hardware ที่มี memory bandwidth สูงขึ้น (เช่น NVIDIA Rubin) และ speculative decoding (ได้ token มากขึ้นต่อการอ่านหนึ่งครั้ง) บทความนี้จะโฟกัสที่ speculative decoding
2. Speculative decoding คืออะไร
Speculative decoding ใช้ประโยชน์จาก compute ที่ว่างอยู่ระหว่าง decode GPU รุ่นใหม่มี compute เหลือเฟือ โมเดลใหญ่จึง verify หลาย token ที่โมเดลเล็กเสนอมาได้ใน forward pass เดียว โดยมี cost แทบเท่ากับการสร้าง token เดียว drafter ที่เล็กกว่าจะเสนอ k token ถัดไป เรียกว่า draft block จากนั้นโมเดลใหญ่ซึ่งเรียกว่า target model จะตรวจทั้งหมดใน pass เดียว ถ้า draft token ตัวไหนถูก reject ระบบจะเก็บ prefix ที่ถูก accept ไว้ แล้วใช้ token จากโมเดลใหญ่แทน
Speedup ที่ได้ขึ้นกับสองเรื่อง คือ draft มี cost ต่ำแค่ไหน และ draft token ถูก accept มากแค่ไหน drafter สองแบบหลักแลกสองเรื่องนี้กันคนละแบบ
2.1 Autoregressive drafter
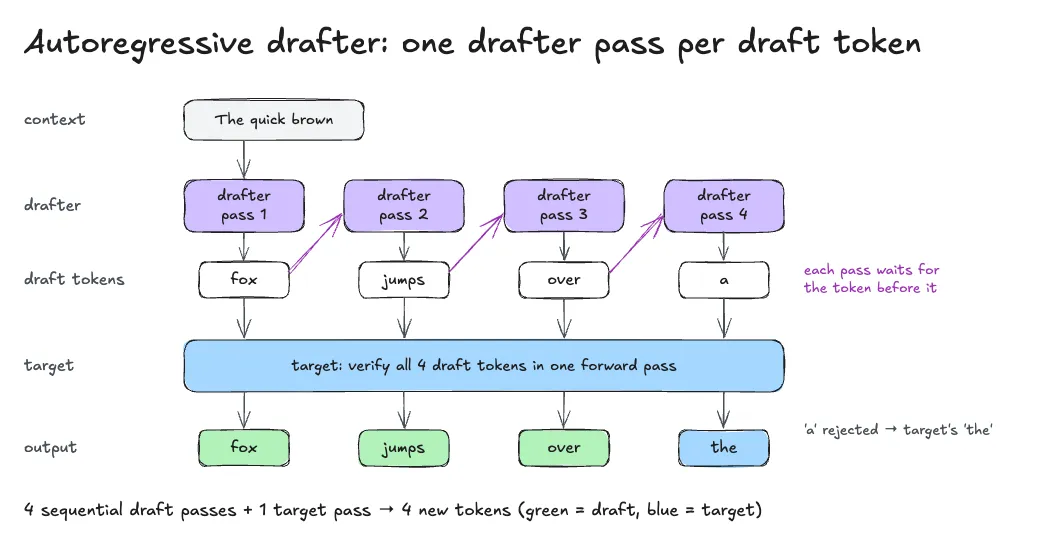
Drafter จะสร้าง k token ทีละตัว โดยแต่ละตัว condition กับตัวก่อนหน้า draft จึงมีคุณภาพสูงเพราะทุก token เห็น token ก่อนหน้า แต่ drafting cost โตแบบ linear ตาม k ทำให้ draft length ต้องสั้น วิธีที่นิยมได้แก่ EAGLE-3 และ MTP ซึ่งมักใช้คู่กับ tree-based verification เพื่อชดเชย draft ที่สั้น
2.2 Parallel drafter
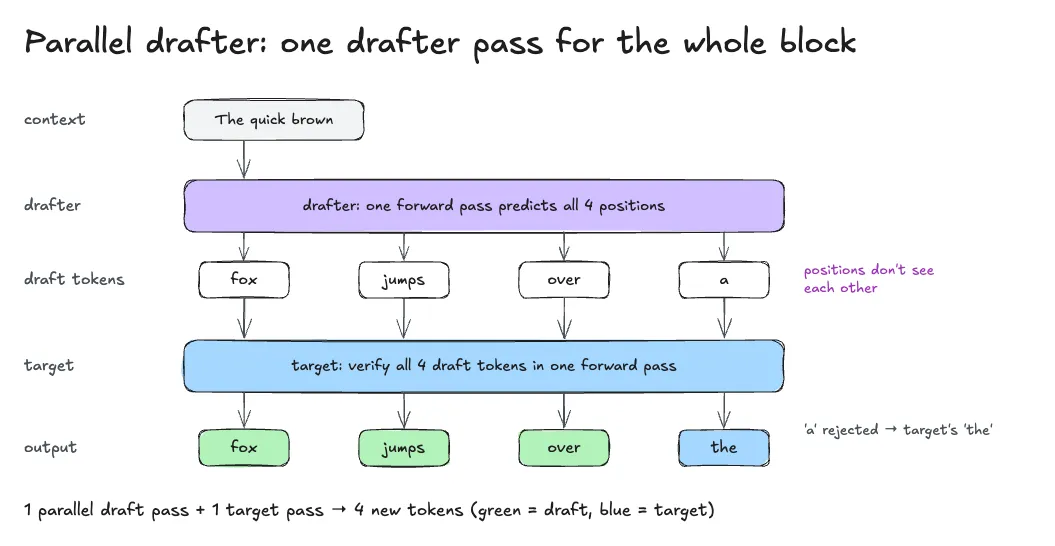
Drafter ทำนายทั้ง k token ใน forward pass เดียว drafting cost จึงแทบคงที่แม้ k จะเพิ่มขึ้น แต่แต่ละ position ถูกทำนายโดยไม่เห็น token จริงที่อยู่ก่อนหน้า acceptance rate จึงลดลงใน position ท้ายๆ ของ block วิธีที่นิยมได้แก่ Medusa, PARD, DART และ DFlash
3. วิธีก่อนหน้ามีปัญหาตรงไหน
3.1 Autoregressive drafter
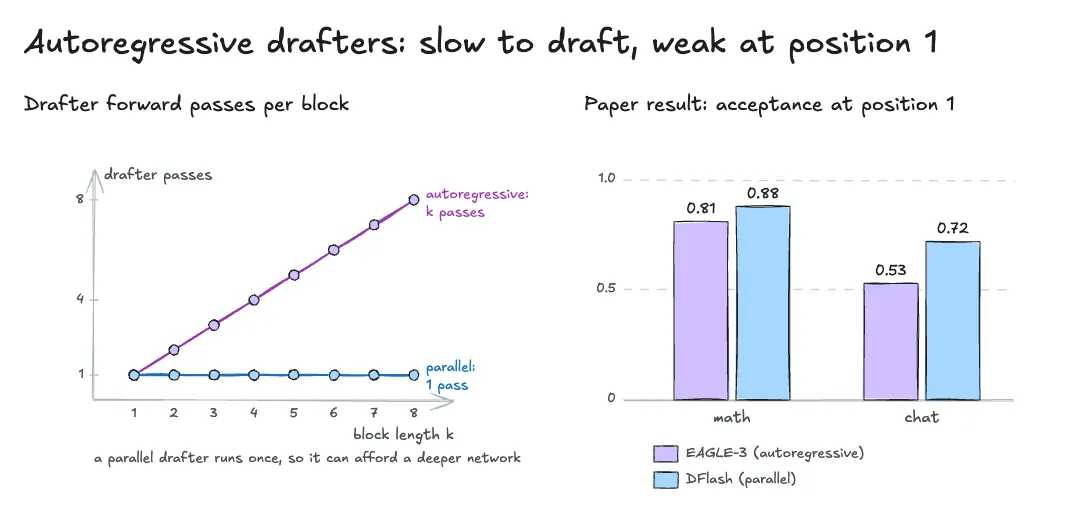
ดังภาพด้านซ้าย draft token แต่ละตัวต้องใช้ drafter forward pass ของตัวเอง drafting latency จึงโตแบบ linear ตาม block length เพื่อคุม latency ให้ต่ำ drafter กลุ่มนี้จึงใช้ block สั้นและ network ที่ตื้น แล้วใช้ tree-based verification ชดเชยด้วยการ verify หลาย candidate path พร้อมกัน ซึ่งทำให้ส่ง token ไปให้ target model มากขึ้น และอาจลด aggregate serving throughput เมื่อมี concurrency สูง
Network ที่ตื้นยัง accurate น้อยกว่า และส่งผลหนักที่สุดที่ draft position แรก เพราะ target accept แค่ prefix ถ้า draft token ตัวแรกผิด ทั้ง block ก็ถูกทิ้ง ดังภาพด้านขวา EAGLE-3 ถูก accept ที่ position แรกน้อยกว่า DFlash ซึ่งเป็น parallel drafter ที่ใช้ network ลึกกว่ามากได้ โดยได้ 0.81 ต่อ 0.88 บน math และ 0.53 ต่อ 0.72 บน chat
3.2 Parallel drafter
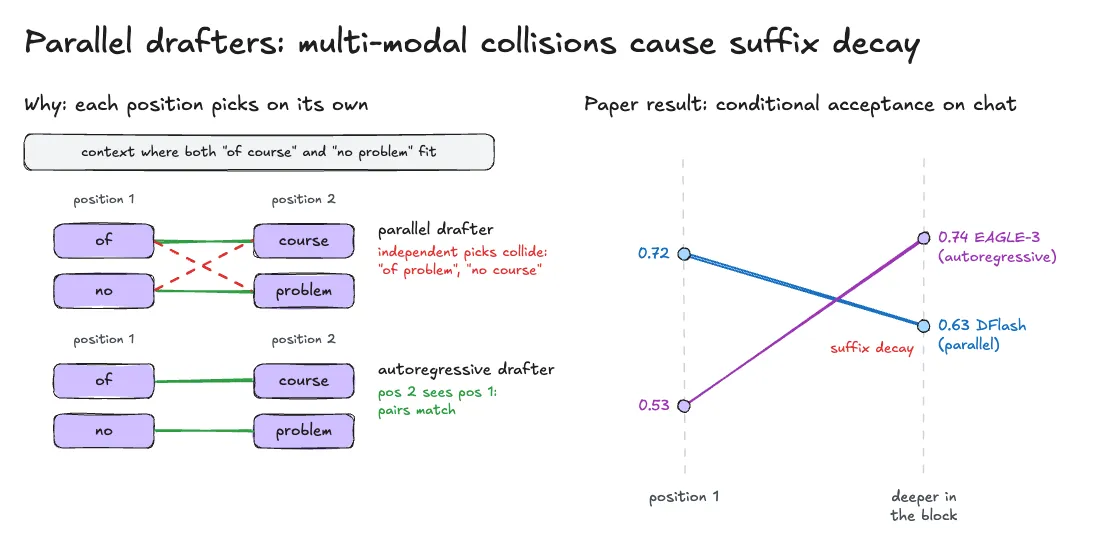
Parallel drafter ทำนายทุก position ใน block ใน forward pass เดียว จึงไม่มี position ไหนรู้ว่า token ก่อนหน้าถูก sample ออกมาเป็นอะไรจริงๆ แต่ละ position ต้องเผื่อทุก token ที่อาจมาก่อนหน้าแทน ผลคือเมื่อ context ต่อได้หลายแบบ แต่ละ position อาจเลือกคนละแบบกัน
ตัวอย่างเช่นภาพด้านซ้าย ถ้าทั้ง “of course” และ “no problem” ใช้ได้ parallel drafter อาจเสนอ “of problem” หรือ “no course” ออกมา เปเปอร์เรียกปัญหานี้ว่า multi-modal collision ซึ่งทำให้เกิด suffix decay คือโอกาสที่ token จะถูก accept มักลดลงใน position ท้ายๆ แม้ token ก่อนหน้าใน block จะถูก accept หมดแล้วก็ตาม สำหรับ parallel drafter ล้วนๆ position ที่เพิ่มเข้ามาใน block ที่ยาวขึ้นจึงมักคุ้มค่าน้อยกว่า position ก่อนหน้า
กราฟด้านขวาแสดง conditional acceptance ของแต่ละ position คือ token ถูก accept บ่อยแค่ไหน เมื่อทุก token ก่อนหน้าถูก accept แล้ว DFlash เริ่มสูงแต่ลดลงตลอด block จาก 0.87 เหลือ 0.78 บน code และจาก 0.72 เหลือ 0.63 บน chat ส่วน EAGLE-3 กลับตรงกันข้าม คือเริ่มต่ำกว่า (0.53 บน chat ซึ่งเป็นตัวเลข position แรกเดียวกับในหัวข้อ 3.1) แต่เพราะแต่ละ token เห็น token ก่อนหน้า จึงคงที่หรือดีขึ้นด้วยซ้ำใน position ลึกๆ ของ block (สูงสุด 0.74 บน chat)
3.3 Verification length
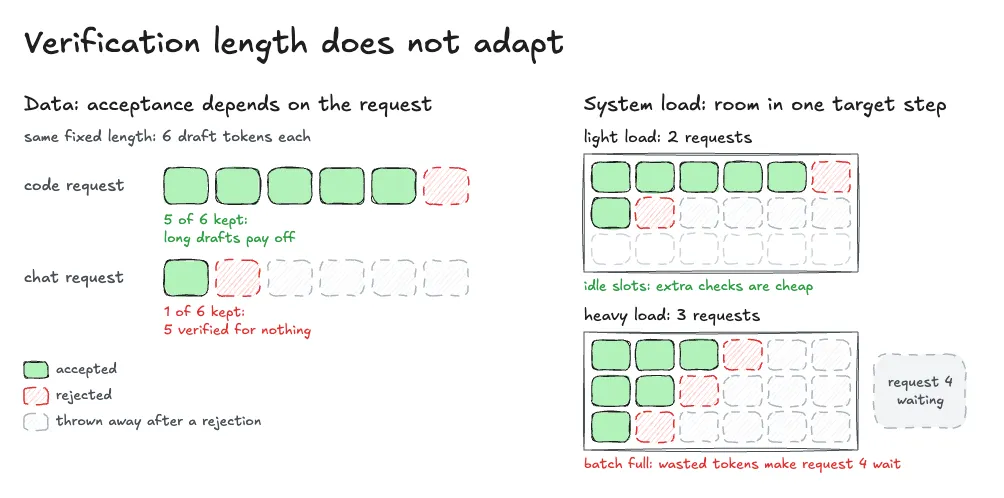
Parallel drafting ทำให้สร้าง block ยาวๆ ได้ถูก แต่การ verify ทุก draft token ไม่ได้ถูกตามไปด้วย verification length ที่เหมาะสมเปลี่ยนไปตามสองแกน
- Data: ภาพด้านซ้าย acceptance ขึ้นกับ request ข้อความที่มีโครงสร้างอย่าง code รักษา acceptance ได้สูงกว่า chat ที่เป็นปลายเปิดมาก length ค่าเดียวจึงสั้นเกินไปสำหรับบาง request และยาวเกินไปสำหรับ request อื่น
- System load: ภาพด้านขวา ที่ light load การ verify token เพิ่มอีกตัวแทบไม่มี cost เพราะ GPU มี capacity เหลือและรอ memory อยู่แล้ว แม้ token ที่ถูก reject ก็แทบไม่เสียอะไร แต่ที่ heavy load ทุก token ที่ส่งไป verify จะเพิ่มขนาด batch ที่ target model ต้องประมวลผลใน step นั้น และ step ก็ช้าลงเมื่อ batch ใหญ่ขึ้น token ที่มีแนวโน้มจะถูก reject จึงไปกิน batch capacity ที่ควรใช้ serve request อื่น
เมื่อรวมกันแล้ว สองวิธีมีจุดอ่อนตรงข้ามกัน autoregressive drafter อ่อนที่ position แรก ส่วน parallel drafter อ่อนลงใน position หลังๆ position แรกสำคัญที่สุด เพราะถ้าพลาดตรงนั้นจะเสียทั้ง block DSpark เล็งช่องว่างนี้ โดยรักษาจุดแข็งของ parallel drafter ที่ position แรกไว้ พร้อมลด decay ใน position หลังๆ
นอกจากนี้ วิธีก่อนหน้ามักจะ verify token จำนวนคงที่ หรือไม่ก็ใช้ confidence threshold แบบ static ซึ่งทั้งสองแบบไม่ได้คำนึงถึง system load ขณะนั้นเลย วิธีเหล่านี้อาจใช้ได้ภายใต้สมมติฐานแบบ single request แต่ไม่เหมาะกับระบบ production ที่มี concurrency สูง ก่อนมี DSpark ระบบ serving ใน production ของ DeepSeek ใช้ MTP-1 คือ draft token เดียว เพราะการใช้ static multi-token drafter (MTP-3 หรือ MTP-5) ทำให้ aggregate throughput ลดลงเมื่อ concurrency สูง
4. DSpark ทำงานอย่างไร
DSpark แก้ปัญหาในหัวข้อ 3 ด้วยสองส่วน ส่วนแรกคือ semi-autoregressive generation ที่รักษา position แรกที่แม่นของ parallel drafter ไว้ และลด suffix decay ใน position ถัดไป ส่วนที่สองคือ confidence-scheduled verification ที่ตัดสินว่า draft token กี่ตัวคุ้มที่จะส่งไปให้ target โดยดูจาก confidence ของ drafter และดูว่า GPU ยุ่งแค่ไหน
4.1 Semi-autoregressive generation
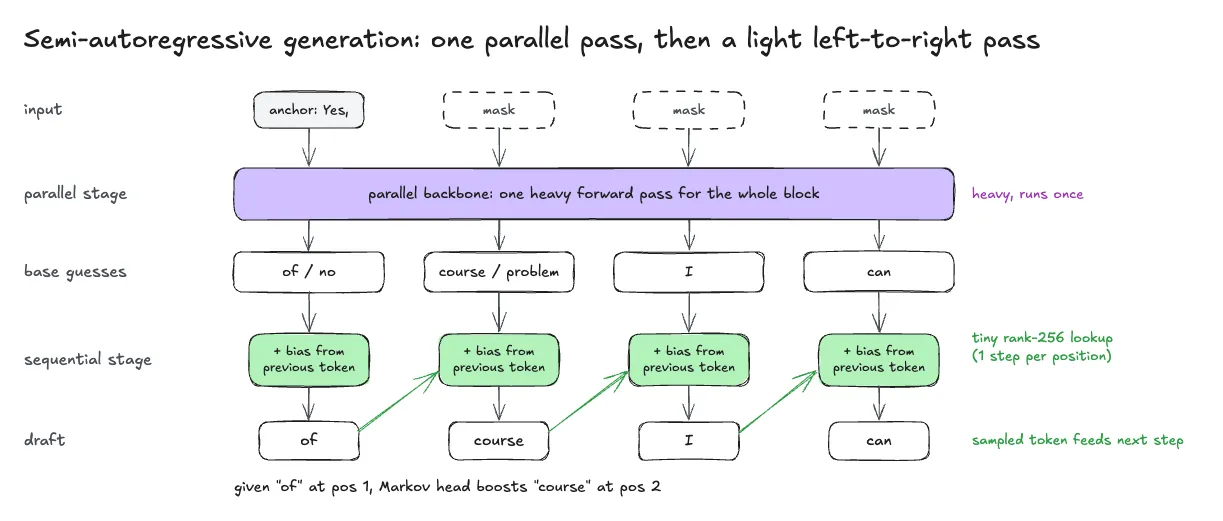
DSpark แบ่งการ draft เป็นสองขั้นตามภาพ ใน parallel stage backbone ขนาดใหญ่ (ในเปเปอร์คือ DFlash) จะรัน forward pass เดียวกับทั้ง block และให้ base guess สำหรับทุก position งาน drafting ส่วนใหญ่เกิดขึ้นตรงนี้ drafting time จึงแทบคงที่แม้ block จะยาวขึ้น จากนั้นใน sequential stage Markov head ตัวเล็กจะไล่ไปตาม block จากซ้ายไปขวา ในแต่ละ position จะเพิ่ม bias ให้ base guess ตาม token ที่เพิ่ง sample ได้ แล้วจึง sample token ถัดไป
ตัวอย่างเช่น ถ้าทั้ง “of course” และ “no problem” ใช้ได้ backbone อย่างเดียวจะเดาว่า “of / no” และ “course / problem” เมื่อ position 1 sample ได้ “of” แล้ว Markov head จะ boost “course” และกด “problem” ที่ position 2 คู่คำจึงยังต่อกันได้ coherent สรุปคือ DSpark ได้ความเร็วแบบ parallel drafter และใช้ sequential head ตัวเล็กช่วยให้คำที่อยู่ติดกัน coherent โดยไม่เสียความเร็วนั้น
Markov head ต้องเล็กเพราะต้องรันหนึ่งครั้งต่อ position ต่อกันไปทีละตัว โดยใช้ low-rank lookup table (ค่า default คือ rank 256) เปเปอร์ยังทดลอง RNN head ที่จำทั้ง prefix แทนที่จะจำแค่ token ก่อนหน้า แต่ได้ gain เพิ่มเพียงเล็กน้อย
4.2 Confidence-scheduled verification
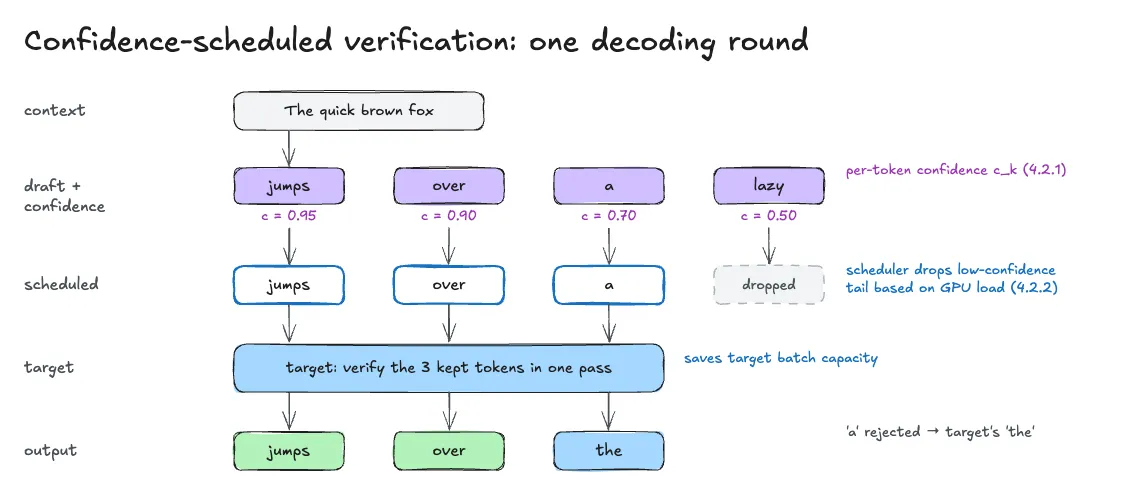
แม้ draft จะดีขึ้นแล้ว การ verify ทุก draft token ก็ยังสิ้นเปลือง เพราะ token ท้ายๆ ของ block มักถูก reject DSpark จึงเพิ่มสองส่วนเพื่อตัดสินว่าจะ verify แต่ละ block แค่ไหน confidence head ให้ confidence score กับ draft token แต่ละตัว และ hardware-aware prefix scheduler ใช้ score เหล่านั้นร่วมกับ GPU load ขณะนั้นเพื่อเลือกว่าจะส่ง token จากแต่ละ request ไปให้ target กี่ตัว
ในภาพ scheduler เก็บ “jumps over a” และตัด “lazy” ทิ้ง target จึง verify แค่สาม token จากนั้น target ทำงานเหมือน speculative decoding ปกติ คือ accept “jumps over” reject “a” และเพิ่ม token ของตัวเองคือ “the” เปเปอร์แสดงว่า scheduling แบบนี้ทำให้ output distribution เหมือนของ target model ทุกประการ
4.2.1 Confidence Head
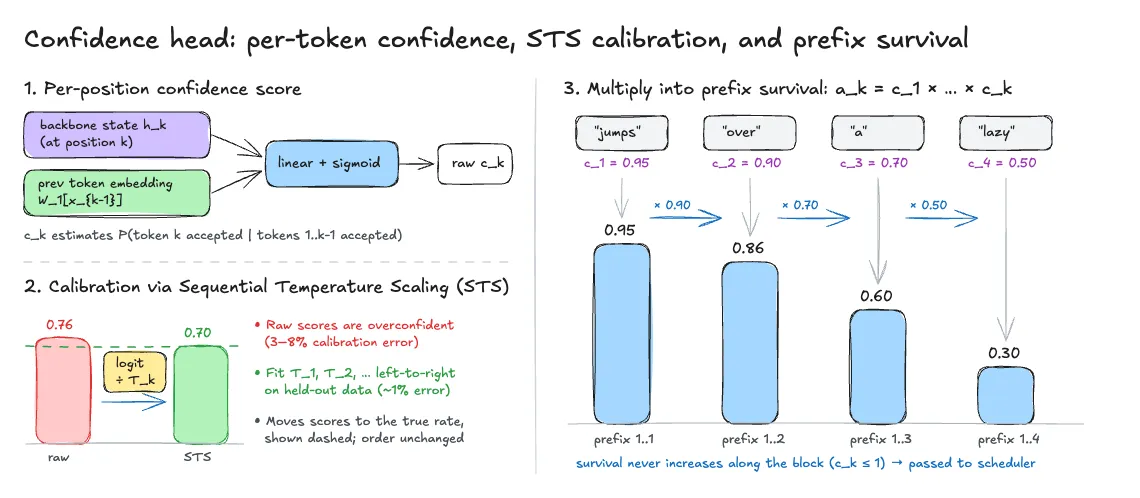
ดังขั้นที่ 1 ในภาพ confidence head คือ linear layer ขนาดเล็กที่มี sigmoid อยู่ด้านบน สำหรับแต่ละ draft position k มันจะดู hidden state ของ backbone และ embedding ของ draft token ก่อนหน้า แล้วให้ score c_k ออกมา ซึ่งคือโอกาสที่ token k จะถูก accept เมื่อทุก token ก่อนหน้าถูก accept แล้ว ระหว่าง training มันเรียนรู้ให้ตรงกับ acceptance rate จริง ซึ่งเปเปอร์คำนวณจากระยะห่างระหว่าง draft distribution กับ target distribution
Raw score จาก neural network มักจะ overconfident DSpark จึง calibrate ก่อน ดังขั้นที่ 2 โดยใช้ Sequential Temperature Scaling (STS) ที่ fit temperature หนึ่งค่าต่อ position จากซ้ายไปขวาบน held-out data วิธีนี้ rescale score ให้ตรงกับ acceptance rate จริงโดยไม่เปลี่ยนลำดับ และลด calibration error จาก 3–8% เหลือราว 1% แต่ c_k แต่ละตัวยังครอบคลุมแค่ position เดียว ขณะที่ target model accept draft token เป็น prefix ต่อเนื่องกัน ในขั้นที่ 3 DSpark จึงคูณ score เข้าด้วยกันเป็น prefix survival probability คือ c_1 × c_2 × … × c_k ซึ่งบอกโอกาสที่ทุก token จนถึง position k จะถูก accept และไม่มีวันเพิ่มขึ้นตลอด block
4.2.2 Hardware-Aware Prefix Scheduler
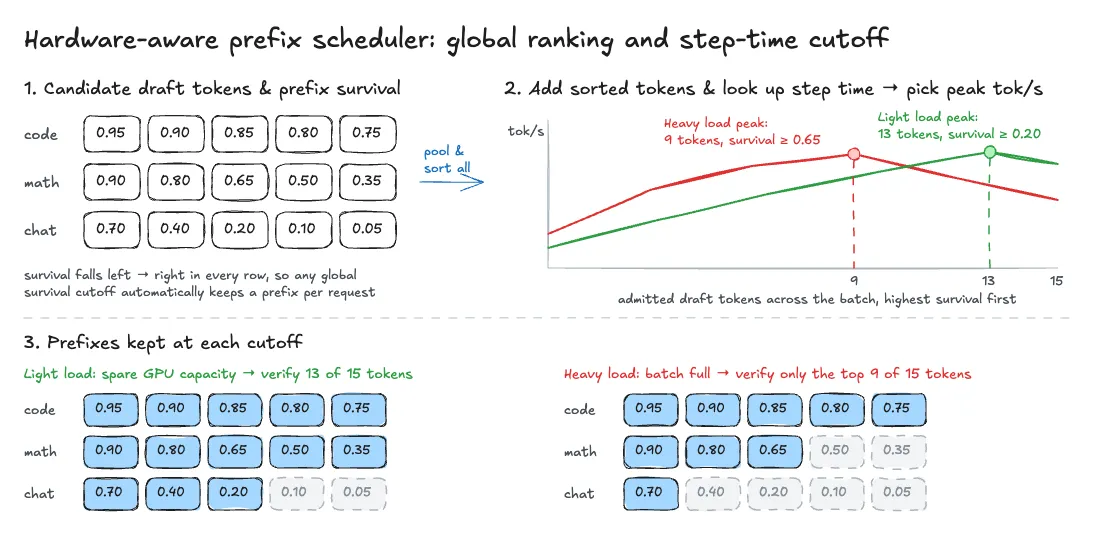
เมื่อได้ survival score แล้ว scheduler จะตัดสินว่าทั้ง batch ควร verify draft token กี่ตัว token ที่เพิ่มแต่ละตัวอาจเพิ่ม accepted output แต่ก็ทำให้ step ของ target ช้าลงด้วย scheduler จะ rank draft token ของทุก request ตาม survival แล้วเพิ่มเข้าไปทีละตัว และเพราะ survival ไม่เคยเพิ่มขึ้นตลอด draft แต่ละ request จึงได้เก็บเป็น prefix เสมอ หลังเพิ่มแต่ละตัว scheduler จะเปิดดู step time จาก table ที่วัดไว้ตอน startup และหยุดทันทีที่ expected accepted tokens per second เริ่มลดลง โดยที่ output ยังคง exact ในภาพ scheduler เก็บ 13 จาก 15 token ที่ light load แต่เก็บแค่ 9 ตัวที่ heavy load
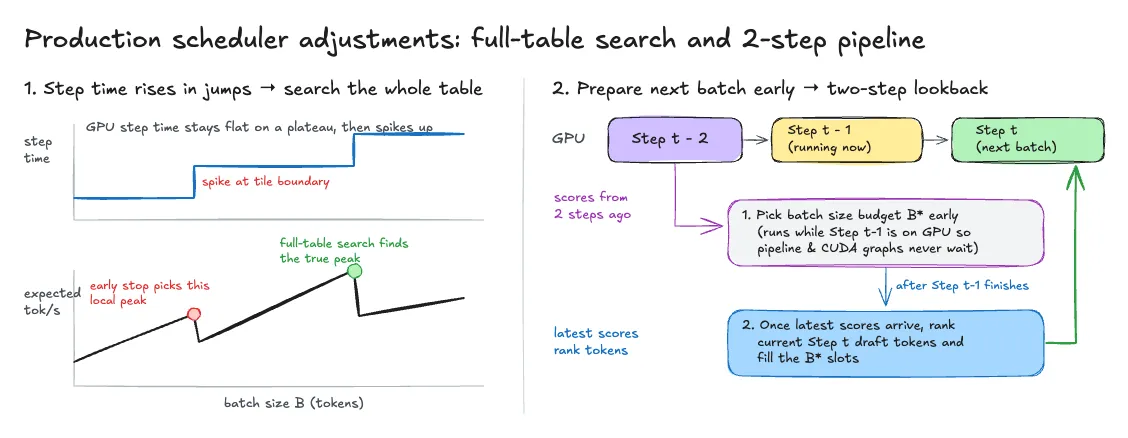
นอกจากนี้ engine ใน production ต้องปรับอีกสองอย่างตามภาพด้านบน ด้านซ้าย GPU step time เพิ่มแบบกระโดดไม่ได้ smooth expected throughput จึงอาจตกลงก่อนถึง peak จริง scheduler จึงค้นทั้ง table แทนที่จะหยุดที่จุดตกแรก ซึ่งไม่มี cost เพิ่มเพราะทุกค่าในตารางวัดไว้แล้วตอน startup ด้านขวา engine เตรียม batch ถัดไประหว่างที่ GPU ยังทำงานอยู่ DSpark จึงกำหนด batch size จาก score เมื่อสอง step ก่อน แล้วเลือก token ด้วย score ล่าสุด เนื่องจาก score เก่าเหล่านั้นถูกกำหนดไว้ก่อนที่ token ปัจจุบันจะเกิดขึ้น full search จึงยังทำให้ output exact
5. ผลการทดลอง
ผลทั้งหมดในหัวข้อนี้มาจากเปเปอร์ DSpark ผู้เขียนยังไม่ได้ reproduce เอง
5.1 Experimental Setup
| Setting | จากเปเปอร์ (Sec. 4.1) |
|---|---|
| Target models | Qwen3-4B, Qwen3-8B, Qwen3-14B, Gemma4-12B |
| Drafters | EAGLE-3 (autoregressive, 1 layer), DFlash (parallel, 5 layers), DSpark (5-layer backbone + Markov head) |
| Block size | 7 สำหรับทุก drafter |
| Training data | 1.3M prompts จาก Open-PerfectBlend (math 39.4%, code 38.9%, chat 17.6%, instruction following 4.1%) โดยให้แต่ละ target model regenerate response ใหม่ train 10 epochs |
| Benchmarks | Math: GSM8K, MATH500, AIME25. Code: MBPP, HumanEval, LiveCodeBench. Chat: MT-Bench, Alpaca, Arena-Hard |
| Decoding | Standard speculative decoding, temperature 1.0, chain drafting, non-thinking mode |
| Metric | Accepted length ต่อรอบ รวม token ของ target เอง (ยิ่งสูงยิ่งดี) |
Drafter ทั้งสามตัว train ด้วย code และ data ชุดเดียวกันใน DeepSpec และปิด confidence scheduler ในการทดสอบ offline นี้ ทุก drafter จึงเสนอ block ยาว 7 token คงที่ เพื่อแยก draft quality ออกจากผลของ scheduling
5.2 Experimental Results
| Target | Drafter | GSM8K | MATH | AIME25 | MBPP | HumanEval | LCB | MT-Bench | Alpaca | Arena-Hard |
|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3-4B | EAGLE-3 | 5.14 | 4.62 | 3.92 | 3.69 | 4.16 | 3.77 | 2.39 | 2.26 | 2.55 |
| DFlash | 5.40 | 4.85 | 4.15 | 4.40 | 4.74 | 4.18 | 3.07 | 2.96 | 2.83 | |
| DSpark | 6.11 | 5.70 | 4.89 | 5.13 | 5.38 | 4.86 | 3.64 | 3.54 | 3.29 | |
| Qwen3-8B | EAGLE-3 | 5.30 | 4.77 | 3.91 | 3.96 | 4.33 | 4.17 | 2.66 | 2.54 | 2.54 |
| DFlash | 5.33 | 4.91 | 4.07 | 4.36 | 4.64 | 4.39 | 3.11 | 2.98 | 2.81 | |
| DSpark | 6.17 | 5.78 | 5.01 | 5.16 | 5.52 | 5.17 | 3.72 | 3.58 | 3.21 | |
| Qwen3-14B | EAGLE-3 | 5.24 | 4.60 | 3.71 | 3.81 | 4.14 | 4.01 | 2.62 | 2.47 | 2.48 |
| DFlash | 5.41 | 4.84 | 3.98 | 4.44 | 4.59 | 4.33 | 3.10 | 2.94 | 2.72 | |
| DSpark | 6.21 | 5.74 | 4.94 | 5.26 | 5.43 | 5.02 | 3.70 | 3.58 | 3.13 | |
| Gemma4-12B | EAGLE-3 | 5.87 | 5.46 | 4.83 | 4.72 | 5.37 | 4.16 | 3.19 | 3.06 | 2.72 |
| DFlash | 5.45 | 5.04 | 4.22 | 4.39 | 4.95 | 3.70 | 2.98 | 2.84 | 2.59 | |
| DSpark | 6.05 | 5.78 | 5.12 | 5.11 | 5.64 | 4.51 | 3.49 | 3.35 | 2.92 |
Accepted length ต่อรอบ จาก Table 1 ของเปเปอร์ LCB คือ LiveCodeBench
DSpark ได้ accepted length ยาวที่สุดในทุก benchmark และทุก target model บน Qwen3-4B, 8B และ 14B DSpark accept token ต่อรอบมากกว่า EAGLE-3 อยู่ 30.9%, 26.7% และ 30.0% และมากกว่า DFlash อยู่ 16.3%, 18.4% และ 18.3% และยังนำเหมือนกันบน Gemma4-12B แสดงว่าการออกแบบนี้ใช้ได้กับ model family อื่นด้วย
มีสอง pattern ในตารางที่น่าสนใจ อย่างแรก acceptance ต่างกันมากตาม task บน Qwen3-4B DSpark ได้ 5.57 token ต่อรอบบน math และ 5.12 บน code เทียบกับ 3.49 บน chat ช่องว่างนี้คือเหตุผลที่ fixed verification length ค่าเดียวจะเปลือง compute กับ prompt ที่ยาก และใช้ประโยชน์ไม่เต็มที่กับ prompt ที่ง่าย อย่างที่สอง EAGLE-3 ชนะ DFlash ในทุก benchmark ของ Gemma4-12B แปลว่า parallel drafter ล้วนๆ ไม่ได้ชนะ autoregressive drafter เสมอไป แต่ DSpark ก็ยังนำทั้งคู่
5.3 Experimental Analysis
1. Position-wise acceptance ยืนยันการออกแบบ
การดู acceptance ในแต่ละ draft position ยืนยันพฤติกรรมในหัวข้อ 3.1 และ 3.2 DSpark รักษา first token ที่แม่นของ parallel backbone ที่ลึกไว้ได้ (acceptance 0.93 บน math ที่ position 1) และ Markov head ทำให้ acceptance สูงและคงที่ตลอด position ที่เหลือ แทนที่จะ decay ลง
2. A little autoregression goes a long way
- Depth: ที่ block ขนาด 7 token DSpark ดีขึ้นทุกครั้งที่เพิ่ม layer จาก 1 ถึง 5 การกระโดดที่ใหญ่ที่สุดอยู่ระหว่าง 1 กับ 2 layers และ DSpark แบบ 2 layers ก็ชนะ DFlash แบบ 5 layers ได้ในทุก domain แล้ว
- Block length: DSpark ชนะ DFlash ในทุก block length ที่ทดสอบ และช่องว่างยิ่งกว้างขึ้นเมื่อ block ยาวขึ้น ที่ 7 draft token DSpark accept มากกว่า 16% บน math, 15% บน code และ 18% บน chat และที่ 15 draft token ตัวเลขเหล่านี้เพิ่มเป็น 30%, 26% และ 22% การเปลี่ยน Markov head เป็น RNN head ให้ gain เพิ่มเพียงเล็กน้อยใน block ที่ยาว
- Cost: ที่ batch size 128 sequential head ของ DSpark ทำให้แต่ละรอบช้ากว่า DFlash เพียง 0.2% ถึง 1.3% ตลอด draft length 4 ถึง 16 token ขณะที่ accept token ได้มากขึ้นถึง 30%
3. Verify smarter, not longer: บทบาทของ confidence scheduling
ก่อนใส่ scheduler เต็มรูปแบบ เปเปอร์ทดสอบ confidence head อย่างเดียว โดยตัด draft token ที่ confidence ต่ำกว่า cutoff คงที่ทิ้ง การเพิ่ม cutoff ช่วยกรอง token ที่ส่วนใหญ่จะถูก reject อยู่แล้ว ดัน acceptance rate ของ token ที่เก็บไว้จาก 45.7% เป็น 95.7% บน chat จาก 76.9% เป็น 92.5% บน math และจาก 67.6% เป็น 92.0% บน code โดย chat ได้ประโยชน์มากที่สุดเพราะ draft token ท้ายๆ พลาดบ่อยกว่า อย่างไรก็ตาม acceptance rate ที่สูงของ token ที่เก็บไว้ไม่ได้การันตีว่า wall-clock จะเร็วขึ้น เพราะถ้าตัดมากเกินไป แต่ละรอบก็จะได้ token น้อยลง และ fixed cutoff ก็ไม่สนใจ GPU load ด้วย นี่คือเหตุผลที่ production serving ใช้ calibrated confidence head คู่กับ hardware-aware scheduler
4. ผลใน production
- Scalability: drafter ใน production ใช้ MoE สาม layers กับ sliding window attention ขนาด 128 บวก Markov head เพื่อให้ training บน long context ยังเร็ว worker จะส่ง hidden state แทน full-vocabulary logits และ pack training block สั้นๆ ไว้รอบ anchor position ที่ sample มา
- Hardware-aware prefix scheduler: การปรับสองอย่างสำหรับ production ในหัวข้อ 4.2.2 ทำให้ scheduler ทำงานร่วมกับ zero-overhead scheduling และ CUDA graphs ได้ โดยไม่เปลี่ยน output distribution
- High throughput with low latency: ใน deployment ของ DeepSeek ข้อจำกัดของ KV cache และ live traffic ทำให้ batch ไม่ถึงจุด compute saturation ของ GPU total throughput ที่สูงขึ้นกับ per-user speed ที่เร็วขึ้นจึงดีขึ้นไปพร้อมกัน เพื่อให้ verify จำนวน token ต่างกันในแต่ละ request ภายใน batch เดียวกันได้ engine จะ flatten ทุก token แล้ว track request ID ของแต่ละตัว ซึ่งต้องแก้แค่สอง kernel (index-attention และ compress)
- Results from real traffic: ที่ moderate load (ต่ำกว่า 200 concurrent requests บน V4-Flash และ 150 บน V4-Pro) scheduler verify ราว 4–6 token ต่อ request (รวม token ของ target เอง) เทียบกับ MTP-1 ที่ fixed ไว้ที่ 2 และจะลด budget นี้ลงเมื่อ load สูงขึ้น DSpark เข้ามาแทน MTP-1 ใน production สองสัปดาห์หลังเปิดตัว DeepSeek-V4 preview
| Engine | Per-user speed target (SLA) | Throughput vs. MTP-1 | Per-user speed ที่ throughput เท่ากัน |
|---|---|---|---|
| V4-Flash | 80 tok/s/user | +51% | เร็วขึ้น 60–85% |
| V4-Flash | 120 tok/s/user | +661% (nominal) | |
| V4-Pro | 35 tok/s/user | +52% | เร็วขึ้น 57–78% |
| V4-Pro | 50 tok/s/user | +406% (nominal) |
จาก Sec. 5.4 ของเปเปอร์ ที่ speed target ที่เข้มงวดกว่า MTP-1 serve ได้แค่ batch เล็กมาก เปเปอร์จึงตีความ +661% และ +406% ว่า DSpark ขยายขอบเขตที่ทำได้ ไม่ใช่ speedup ตามปกติ
5.4 Limitations และ Future Work
ข้อจำกัดหนึ่งที่เปเปอร์ระบุไว้คือ scheduler ช่วยลดงานได้เฉพาะฝั่ง target model ส่วน drafter ยังรัน parallel backbone เต็มทั้ง block ในทุก step แม้กับ request ที่ยากซึ่งสุดท้าย scheduler ตัด draft token ทิ้งเกือบหมด ทีมผู้วิจัยเสนอให้เพิ่ม difficulty-aware early exit ไว้ใน drafter เพื่อให้ prompt ที่ยากข้ามการสร้าง block เต็มได้
ในมุมของผู้เขียน ยังมี trade-off อีกสองสามข้อที่ควรคำนึงถึง
- Offline table วัด draft quality ไม่ใช่ speed: Table 1 รันโดยปิด confidence scheduler และใช้ block size คงที่ 7 ซึ่งเป็นวิธีเปรียบเทียบ drafter ที่ clean แต่ end-to-end speedup จริงยังขึ้นกับ drafter overhead, batch size และ step time ของ target
- การใช้ score จากสอง step ก่อนอาจตามการเปลี่ยนแปลงกะทันหันไม่ทัน: ในการออกแบบของเปเปอร์ batch size ถูกเลือกจาก score เมื่อสอง step ก่อน ซึ่งได้ผลดีเมื่อ acceptance ค่อนข้างคงที่ในแต่ละรอบ แต่ถ้า request หนึ่งเปลี่ยนจาก code ที่คาดเดาได้ไปเป็นการเขียนแบบปลายเปิดกะทันหัน จำนวน token ที่ scheduler verify จะต้องใช้สองรอบกว่าจะตามทัน
6. Demo
vLLM รองรับ DSpark ทั้งสองส่วนแล้ว การตั้ง "method": "dspark" จะรัน semi-autoregressive drafter จากหัวข้อ 4.1 และการตั้ง "enable_adaptive_verification": true จะเพิ่ม confidence-scheduled verification จากหัวข้อ 4.2 เมื่อเปิด adaptive verification แล้ว vLLM จะ score draft token แต่ละตัวด้วย confidence head ของ checkpoint และใช้ step-time table ที่ profile ไว้ตอน startup เพื่อตัดสินว่าแต่ละ request ควร verify กี่ token
แต่ละขั้นด้านล่างเป็นคำสั่งสำหรับเครื่อง GPU ของคุณเอง ถ้าต้องการรันขั้นเดียวกันบน H100 ของ Modal ให้เปิด รันบน Modal ที่อยู่ใต้แต่ละขั้น
1. ติดตั้ง vLLM
ขั้นแรก ติดตั้ง vLLM ใน Python environment โดยในเดโมนี้จะใช้ bench extra เพื่อทดสอบ DSpark จากนั้นรัน vllm download-kernels เพื่อติดตั้ง precompiled kernel ของ FlashInfer ช่วยลด startup time แม้จะใช้ Triton attention แต่ vLLM ก็ยังใช้ FlashInfer ในบาง operation
pip install -U "vllm[bench]"
vllm download-kernels
รันบน Modal
Modal จะรันการติดตั้งเดียวกันใน container image และทุกการรันจะได้ H100 ของตัวเอง ขั้นแรก ติดตั้ง Modal client แล้ว login
pip install modal
modal setup
จากนั้นสร้าง dspark_modal.py ฟังก์ชัน run ในไฟล์นี้ทำหน้าที่แทนทั้งสอง terminal คือ start คำสั่งฝั่ง server ไว้ใน background รอจน server ตอบ รันคำสั่งฝั่ง client แล้วหยุด server เหมือนกด Ctrl+C ส่วน ! ใน H100! จะกันไม่ให้ Modal ย้ายไปรันบน H200
cat > dspark_modal.py <<'EOF'
import os
import signal
import subprocess
import time
import urllib.request

import modal

app = modal.App("dspark-demo")

# Step 1 on Modal: a container image with vLLM installed
image = (
    modal.Image.from_registry("nvidia/cuda:13.0.3-devel-ubuntu24.04", add_python="3.12")
    .entrypoint([])
    .apt_install("curl")
    .uv_pip_install("vllm[bench]")
    .run_commands("vllm download-kernels", gpu="H100")  # vllm needs a GPU to start
)

# Keep downloaded models and compiled kernels between runs
volumes = {
    "/root/.cache/huggingface": modal.Volume.from_name("dspark-hf-cache", create_if_missing=True),
    "/root/.cache/vllm": modal.Volume.from_name("dspark-vllm-cache", create_if_missing=True),
}


@app.function(image=image, gpu="H100!", volumes=volumes, timeout=60 * 60)
def run(server: str, client: str):
    # Terminal 1: start the server in the background
    server_process = subprocess.Popen(["bash", "-c", server], start_new_session=True)

    # Wait until the server answers, which happens after "Application startup complete"
    while True:
        try:
            urllib.request.urlopen("http://localhost:8000/health")
            break
        except OSError:
            if server_process.poll() is not None:
                raise RuntimeError("vllm serve exited before it was ready")
            time.sleep(5)

    # Terminal 2: run the client commands against the server
    subprocess.run(["bash", "-c", client], check=True)

    # Wait for the server's next stats log, then stop it like Ctrl+C
    time.sleep(15)
    os.killpg(server_process.pid, signal.SIGINT)
    server_process.wait()


@app.local_entrypoint()
def main(server: str, client: str):
    with open(server) as server_file, open(client) as client_file:
        run.remote(server_file.read(), client_file.read())
EOF
2. Launch vLLM พร้อม DSpark
ใช้ --speculative-config เพื่อตั้งค่า DSpark drafter ให้ตรงกับ target model ของคุณ drafter ของ Qwen3 ที่ release ออกมาถูก train โดยปิด thinking mode server จึงปิด thinking mode ด้วย และปิด prefix caching เพื่อไม่ให้การรัน benchmark ซ้ำไป reuse prompt ที่ cache ไว้จนผลดูดีเกินจริง นอกจากนี้ adaptive verification ต้องใช้ attention backend ที่ CUDA graphs รองรับจำนวน token ต่างกันในแต่ละ request บน GPU อย่าง A100, L40S และ RTX PRO 6000 backend default ของ vLLM คือ FlashAttention 2 ทำแบบนี้ไม่ได้และจะ fail ตอน startup server จึงใช้ Triton attention แทน
# Terminal 1: start the server
vllm serve Qwen/Qwen3-8B \
  --max-model-len 16384 \
  --gpu-memory-utilization 0.85 \
  --no-enable-prefix-caching \
  --attention-backend TRITON_ATTN \
  --default-chat-template-kwargs '{"enable_thinking": false}' \
  --speculative-config '{
    "method": "dspark",
    "model": "deepseek-ai/dspark_qwen3_8b_block7",
    "num_speculative_tokens": 7,
    "enable_adaptive_verification": true
  }'
เมื่อ log แสดง Application startup complete แล้ว ให้ส่ง test request จาก terminal ที่สอง
# Terminal 2: send a test request
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen3-8B",
    "messages": [
      {"role": "user", "content": "Write a Python function for binary search."}
    ],
    "max_tokens": 256,
    "temperature": 0
  }'
รันบน Modal
บันทึกคำสั่ง server และ test request เป็นไฟล์ แล้วรันทั้งคู่บน Modal การรันครั้งแรกใช้เวลาราวสิบนาที เพราะต้อง build image และดาวน์โหลดโมเดลทั้งสองตัว ครั้งต่อไปจะใช้ของเดิมและ start ได้ในราวสามนาที
# Save the server command
cat > server.sh <<'EOF'
vllm serve Qwen/Qwen3-8B \
  --max-model-len 16384 \
  --gpu-memory-utilization 0.85 \
  --no-enable-prefix-caching \
  --attention-backend TRITON_ATTN \
  --default-chat-template-kwargs '{"enable_thinking": false}' \
  --speculative-config '{
    "method": "dspark",
    "model": "deepseek-ai/dspark_qwen3_8b_block7",
    "num_speculative_tokens": 7,
    "enable_adaptive_verification": true
  }'
EOF
# Save the test request
cat > client.sh <<'EOF'
curl http://localhost:8000/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "Qwen/Qwen3-8B",
"messages": [
{"role": "user", "content": "Write a Python function for binary search."}
],
"max_tokens": 256,
"temperature": 0
}'
EOF# Run both on a Modal H100
modal run dspark_modal.py --server server.sh --client client.sh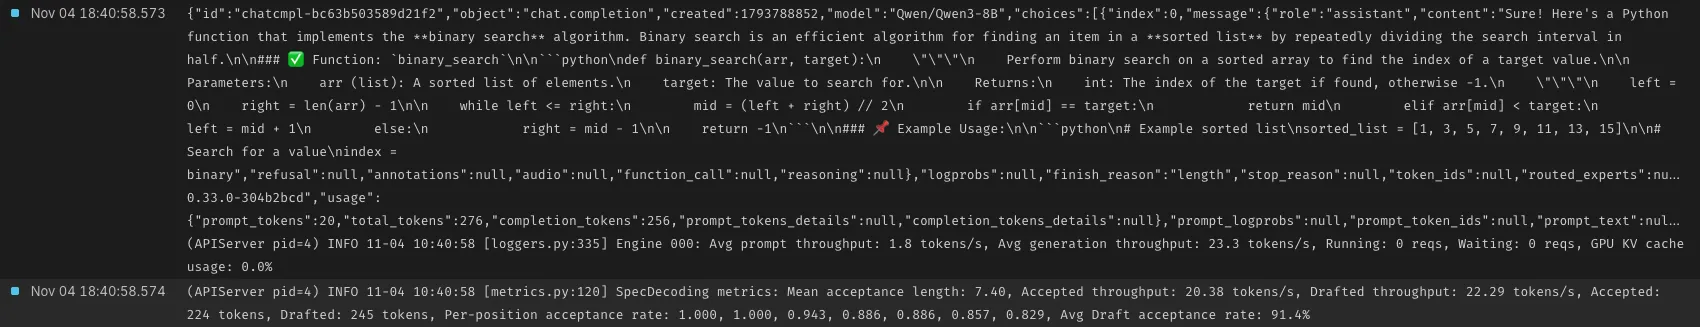
Reply ควรหน้าตาเหมือนคำตอบปกติของ Qwen3-8B ใน log ของ server บรรทัดที่ขึ้นต้นด้วย SpecDecoding metrics จะรายงาน mean acceptance length คือจำนวน token เฉลี่ยที่แต่ละรอบสร้างได้ รวม token ของ target model เอง
3. Benchmark ที่ light load และ heavy load
ในเดโมนี้ เราจะเปรียบเทียบ light load ที่ส่งทีละ request กับ heavy load ที่มี 64 request in flight ตลอดเวลา ในสาม setup คือไม่ใช้ speculative decoding, speculative decoding ด้วย EAGLE-3 และ speculative decoding ด้วย DSpark
3.1 เตรียม benchmark script
บันทึกแต่ละ load เป็น script ไว้ใช้ซ้ำกับทุก server
# Light load, one request at a time
cat > light.sh <<'EOF'
vllm bench serve \
  --backend openai-chat --endpoint /v1/chat/completions \
  --model Qwen/Qwen3-8B --skip-chat-template \
  --dataset-name hf --dataset-path philschmid/mt-bench \
  --num-prompts 80 --max-concurrency 1
EOF
# Heavy load, 64 requests at a time
cat > heavy.sh <<'EOF'
vllm bench serve \
--backend openai-chat --endpoint /v1/chat/completions \
--model Qwen/Qwen3-8B --skip-chat-template \
--dataset-name hf --dataset-path philschmid/mt-bench \
--num-prompts 320 --max-concurrency 64
EOF3.2 ไม่ใช้ speculative decoding
นี่คือ baseline ที่ target model สร้าง token ทีละตัวต่อ step
# Terminal 1: start the server
vllm serve Qwen/Qwen3-8B \
  --max-model-len 16384 \
  --gpu-memory-utilization 0.85 \
  --no-enable-prefix-caching \
  --attention-backend TRITON_ATTN \
  --default-chat-template-kwargs '{"enable_thinking": false}'
# Terminal 2: light load
bash light.sh# Terminal 2: heavy load
bash heavy.shรันบน Modal
# Save the server command
cat > server.sh <<'EOF'
vllm serve Qwen/Qwen3-8B \
  --max-model-len 16384 \
  --gpu-memory-utilization 0.85 \
  --no-enable-prefix-caching \
  --attention-backend TRITON_ATTN \
  --default-chat-template-kwargs '{"enable_thinking": false}'
EOF
# Light load on a Modal H100
modal run dspark_modal.py --server server.sh --client light.sh# Heavy load on a Modal H100
modal run dspark_modal.py --server server.sh --client heavy.sh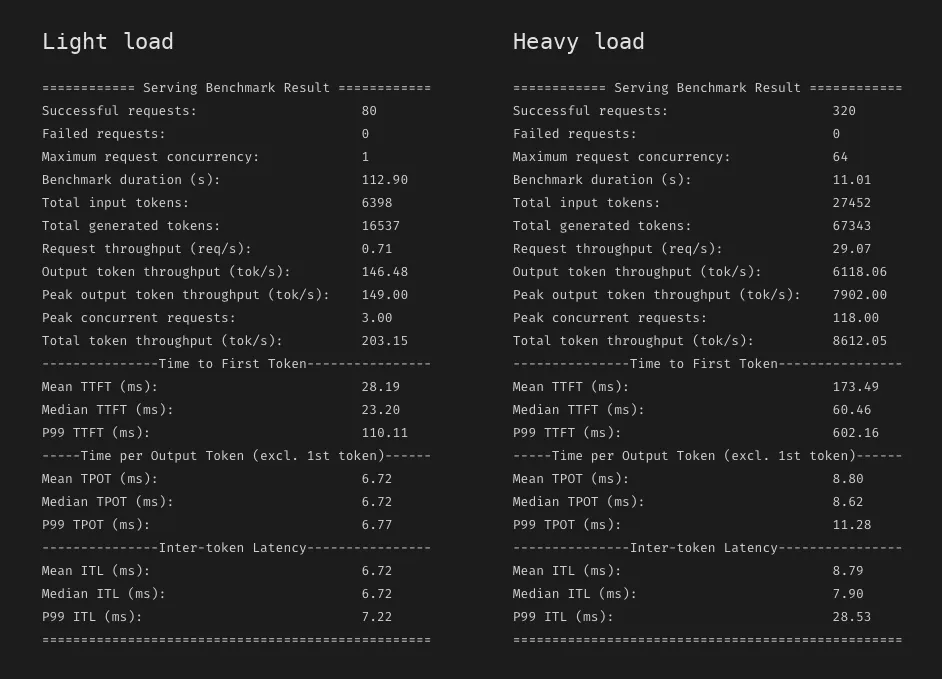
3.3 Speculative decoding ด้วย EAGLE-3
EAGLE-3 draft ทีละ token draft token ที่เพิ่มแต่ละตัวจึงต้องรัน drafter อีกหนึ่ง pass EAGLE-3 drafter สำหรับ Qwen3-8B ของ Red Hat ถูก train โดยปิด thinking mode และใน model card รันด้วย draft สาม token ข้อมูลที่ใช้ train ต่างจาก drafter ของ DeepSeek การทดสอบนี้จึงเป็นการเทียบ drafter ที่ release ออกมาจริง ไม่ใช่การ reproduce Table 1 ของเปเปอร์
# Terminal 1: start the server
vllm serve Qwen/Qwen3-8B \
  --max-model-len 16384 \
  --gpu-memory-utilization 0.85 \
  --no-enable-prefix-caching \
  --attention-backend TRITON_ATTN \
  --default-chat-template-kwargs '{"enable_thinking": false}' \
  --speculative-config '{
    "method": "eagle3",
    "model": "RedHatAI/Qwen3-8B-speculator.eagle3",
    "num_speculative_tokens": 3
  }'
# Terminal 2: light load
bash light.sh# Terminal 2: heavy load
bash heavy.shรันบน Modal
# Save the server command
cat > server.sh <<'EOF'
vllm serve Qwen/Qwen3-8B \
  --max-model-len 16384 \
  --gpu-memory-utilization 0.85 \
  --no-enable-prefix-caching \
  --attention-backend TRITON_ATTN \
  --default-chat-template-kwargs '{"enable_thinking": false}' \
  --speculative-config '{
    "method": "eagle3",
    "model": "RedHatAI/Qwen3-8B-speculator.eagle3",
    "num_speculative_tokens": 3
  }'
EOF
# Light load on a Modal H100
modal run dspark_modal.py --server server.sh --client light.sh# Heavy load on a Modal H100
modal run dspark_modal.py --server server.sh --client heavy.sh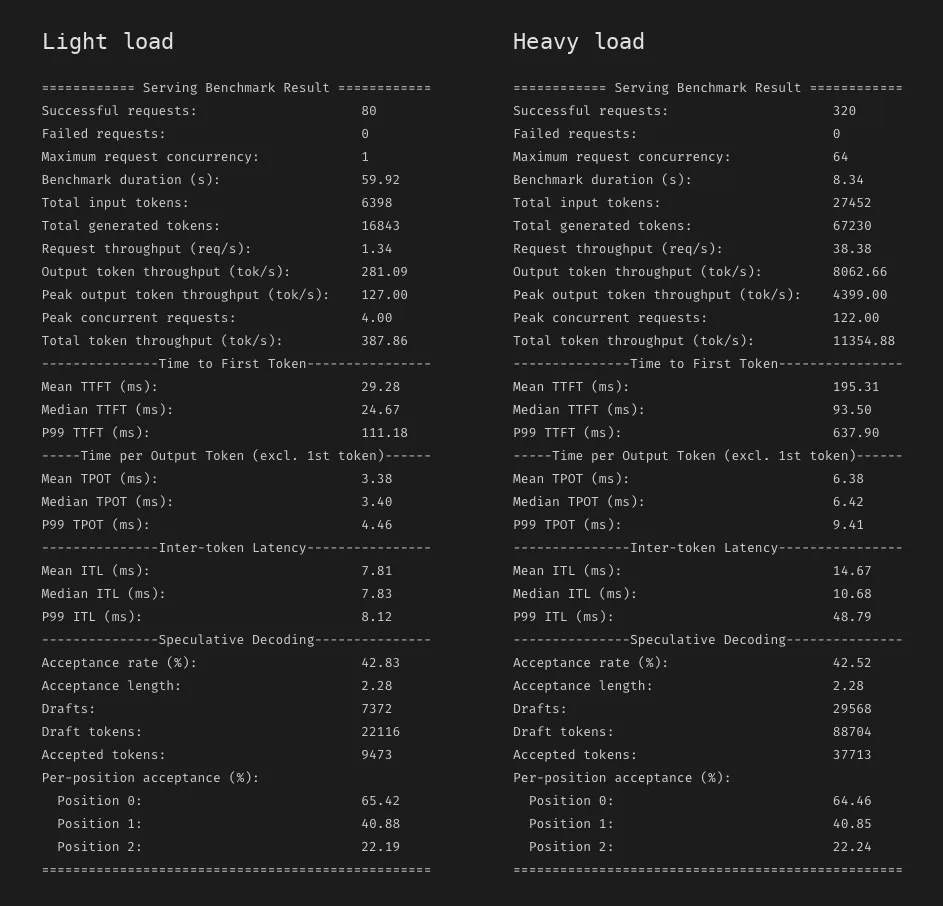
3.4 Speculative decoding ด้วย DSpark
3.4.1 Draft length แบบ fixed
ใช้ DSpark drafter ตัวเดียวกับขั้นที่ 2 แต่ปิด adaptive verification ทุก request จึง verify ครบทั้ง 7 draft token เหมือน standard speculative decoding
# Terminal 1: start the server
vllm serve Qwen/Qwen3-8B \
  --max-model-len 16384 \
  --gpu-memory-utilization 0.85 \
  --no-enable-prefix-caching \
  --attention-backend TRITON_ATTN \
  --default-chat-template-kwargs '{"enable_thinking": false}' \
  --speculative-config '{
    "method": "dspark",
    "model": "deepseek-ai/dspark_qwen3_8b_block7",
    "num_speculative_tokens": 7,
    "enable_adaptive_verification": false
  }'
# Terminal 2: light load
bash light.sh# Terminal 2: heavy load
bash heavy.shรันบน Modal
# Save the server command
cat > server.sh <<'EOF'
vllm serve Qwen/Qwen3-8B \
  --max-model-len 16384 \
  --gpu-memory-utilization 0.85 \
  --no-enable-prefix-caching \
  --attention-backend TRITON_ATTN \
  --default-chat-template-kwargs '{"enable_thinking": false}' \
  --speculative-config '{
    "method": "dspark",
    "model": "deepseek-ai/dspark_qwen3_8b_block7",
    "num_speculative_tokens": 7,
    "enable_adaptive_verification": false
  }'
EOF
# Light load on a Modal H100
modal run dspark_modal.py --server server.sh --client light.sh# Heavy load on a Modal H100
modal run dspark_modal.py --server server.sh --client heavy.sh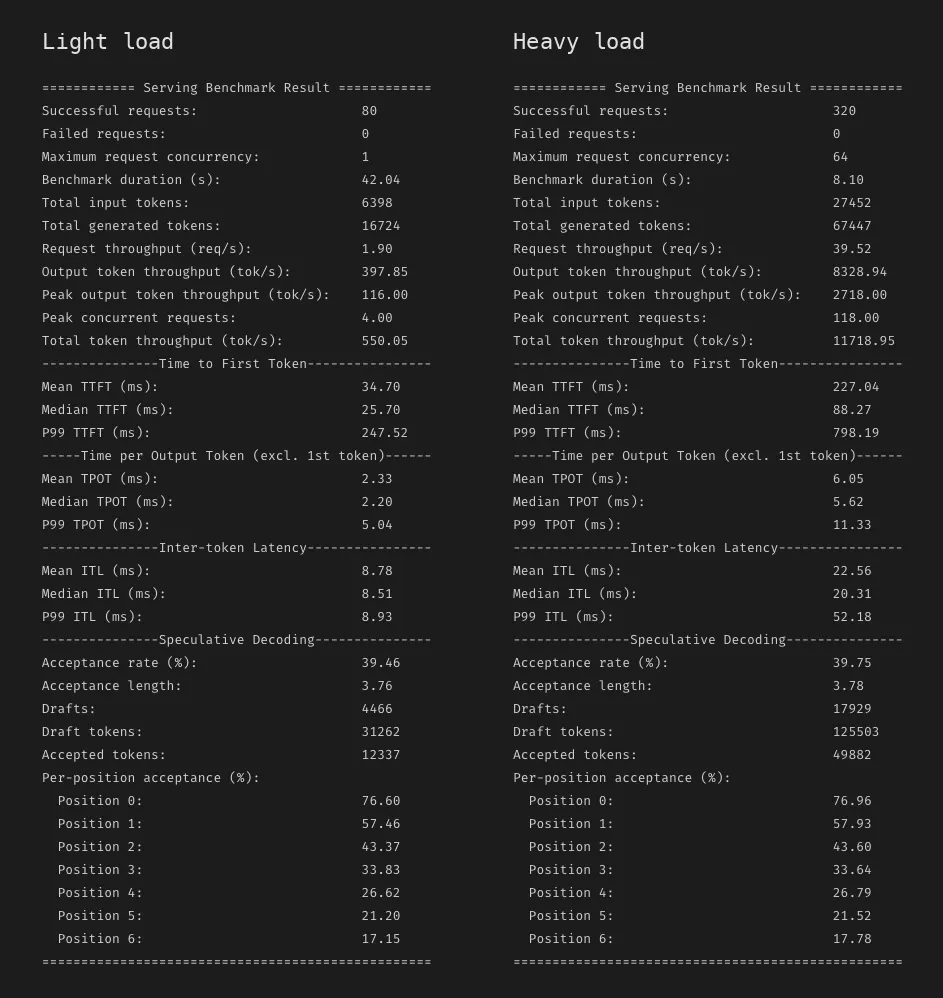
3.4.2 เปิด adaptive verification
นี่คือ server เดียวกับขั้นที่ 2 ที่เปิดทั้ง drafter และ adaptive verification
# Terminal 1: start the server
vllm serve Qwen/Qwen3-8B \
  --max-model-len 16384 \
  --gpu-memory-utilization 0.85 \
  --no-enable-prefix-caching \
  --attention-backend TRITON_ATTN \
  --default-chat-template-kwargs '{"enable_thinking": false}' \
  --speculative-config '{
    "method": "dspark",
    "model": "deepseek-ai/dspark_qwen3_8b_block7",
    "num_speculative_tokens": 7,
    "enable_adaptive_verification": true
  }'
# Terminal 2: light load
bash light.sh# Terminal 2: heavy load
bash heavy.shรันบน Modal
# Save the server command
cat > server.sh <<'EOF'
vllm serve Qwen/Qwen3-8B \
  --max-model-len 16384 \
  --gpu-memory-utilization 0.85 \
  --no-enable-prefix-caching \
  --attention-backend TRITON_ATTN \
  --default-chat-template-kwargs '{"enable_thinking": false}' \
  --speculative-config '{
    "method": "dspark",
    "model": "deepseek-ai/dspark_qwen3_8b_block7",
    "num_speculative_tokens": 7,
    "enable_adaptive_verification": true
  }'
EOF
# Light load on a Modal H100
modal run dspark_modal.py --server server.sh --client light.sh# Heavy load on a Modal H100
modal run dspark_modal.py --server server.sh --client heavy.sh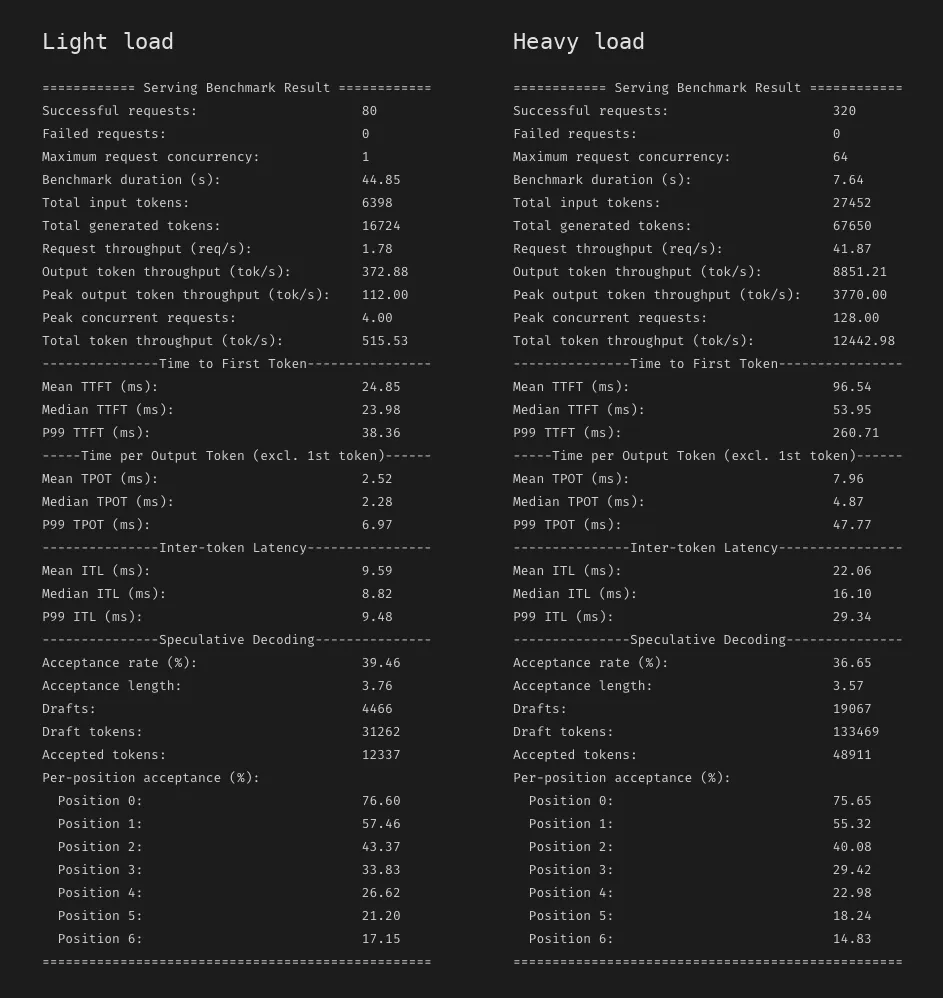
3.5 ผลลัพธ์
ตารางด้านล่างรวมผลที่ heavy load จาก screenshot ข้างต้น ทั้งหมดรันบน H100 ของ Modal
| Heavy load | Output (tok/s) | Speedup | Mean TTFT (ms) | Mean TPOT (ms) | Median TPOT (ms) | P99 TPOT (ms) | Acceptance length |
|---|---|---|---|---|---|---|---|
| Baseline | 6118.06 | 1.00× | 173.49 | 8.80 | 8.62 | 11.28 | – |
| EAGLE-3 | 8062.66 | 1.32× | 195.31 | 6.38 | 6.42 | 9.41 | 2.28 |
| DSpark, fixed | 8328.94 | 1.36× | 227.04 | 6.05 | 5.62 | 11.33 | 3.78 |
| DSpark, adaptive | 8851.21 | 1.45× | 96.54 | 7.96 | 4.87 | 47.77 | 3.57 |
ที่ heavy load ผลเหล่านี้สอดคล้องกับเปเปอร์ในสองแง่
- Acceptance length: ที่ fixed draft length DSpark accept 3.78 token ต่อรอบบน MT-Bench ใกล้กับ 3.72 ที่เปเปอร์รายงานไว้สำหรับ Qwen3-8B ใน Table 1
- Adaptive verification: accept token ต่อรอบน้อยกว่า คือ 3.57 เทียบกับ 3.78 แต่ให้ throughput สูงที่สุด และ mean TTFT ต่ำกว่าครึ่งหนึ่งของแบบ fixed length เพราะการ verify token น้อยลงช่วยปกป้อง batch
7. Takeaways
- Drafting กับ verification แก้ปัญหาคนละเรื่อง parallel backbone ที่ลึกกับ Markov head ตัวเล็กทำให้ draft block ที่ยาวและ coherent ได้ในราคาถูก ขณะที่ scheduler ที่แยกออกมาเป็นตัวตัดสินว่า token เหล่านั้นคุ้มที่จะส่งไปให้ target model กี่ตัว
- Accepted tokens per round ไม่ใช่ metric เดียวที่สำคัญ ใน production เป้าหมายจริงคือ total system throughput ภายใต้ latency target ซึ่งขึ้นกับ batch load พอๆ กับ draft accuracy
- Draft length ควรเป็น scheduling decision แบบ real-time การ verify draft token มากขึ้นคุ้มเมื่อ GPU ยังมีที่ว่าง และการ verify น้อยลงช่วยปกป้อง batch เมื่อ traffic หนัก
เปเปอร์: Xin Cheng, Xingkai Yu, Chenze Shao, Jiashi Li, Yunfan Xiong และผู้เขียนร่วมอีก 28 คน (DeepSeek-AI และ Peking University), “DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation”, arXiv:2607.05147, กรกฎาคม 2026 ภาพทั้งหมดยกเว้น screenshot ของเดโมเป็นภาพที่วาดใหม่เพื่อประกอบคำอธิบาย ส่วนตัวอย่างและตัวเลขที่อ้างถึงเปเปอร์อ้างอิงจากเปเปอร์ DSpark