สรุปงาน · วันเสาร์ที่ 24 ตุลาคม 2569 · ห้องประชุม ASIC ชั้น 31 อาคาร MS Siam

Ray Summit 2026 Recap

เช้าวันเสาร์ที่ 24 ตุลาคม 2026 สปีกเกอร์หกคนจากคอมมูนิตี้มาเล่าคีย์โน้ตและข่าวของ Ray กับ vLLM จาก Ray Summit 2026 ให้ทีมที่ให้บริการโมเดลในไทยฟัง ที่นี่รวมสไลด์ของแต่ละหัวข้อและภาพบรรยากาศของเช้าวันนั้น

จัดโดย vLLM Bangkok ร่วมกับ AGICAFET · โดยความร่วมมือกับ Anyscale ↗ · สถานที่สนับสนุนโดย SVOA ↗

สไลด์แต่ละหัวข้อ

แต่ละหัวข้อพร้อมสไลด์ที่สปีกเกอร์แชร์ให้ เรียงตามกำหนดการ

  1. หัวข้อที่ 01 ·

    Opening & What’s Ray and vLLM + Serving a Frontier Open Model with Ray & vLLM

    Natdhanai Praneenatthavee · CEO & CAIO · AGICAFET

    เซสชันต้นฉบับ: Eyal Lantzman, Nscale ↗

    Natdhanai Praneenatthavee เปิดงานด้วยภาพรวม Ray Summit 2026 (ซานฟรานซิสโก 24–26 สิงหาคม): คีย์โน้ต เบรกเอาต์ vLLM Conference ครั้งแรก และความเคลื่อนไหวทางธุรกิจเบื้องหลัง Ray กับ vLLM ต่อด้วยพื้นฐานสำหรับมือใหม่ว่า Ray, vLLM และ Ray Serve LLM ทำงานร่วมกันอย่างไร ช่วงที่ 3 เล่าใหม่จากเบรกเอาต์ Ray Summit ของ Eyal Lantzman จาก Nscale ว่าด้วยการเสิร์ฟ DeepSeek-V4-Flash ด้วย Ray และ vLLM: deployment shape สี่แบบบน 8x B200, prefill/decode disaggregation และ cache เบื้องหลัง context window 1M token

    เนื้อหาในสไลด์
    • เปิดงาน: ทำไมต้องสรุป Ray Summit เป็นภาษาไทย และเส้นทางของ vLLM Bangkok: สามงานในปี 2026
    • Ray Summit 2026 ในหกตัวเลข คีย์โน้ตที่ RL กลายเป็นโจทย์วิศวกรรมระดับ production และเบรกเอาต์ที่มีรูปแบบเดียวกัน: Ray cluster เดียวอยู่เบื้องหลังทั้ง data, training และ serving
    • vLLM Conference ครั้งแรก และหัวข้อไหนของวันนี้ที่เล่าต่อจากเซสชันในงานนั้น ตามด้วยสามความเคลื่อนไหวทางธุรกิจ: Nscale ตกลงซื้อกิจการ Anyscale, Inferact เปิดตัวด้วยเงินทุน seed $150M และ Ray เข้าร่วม PyTorch Foundation
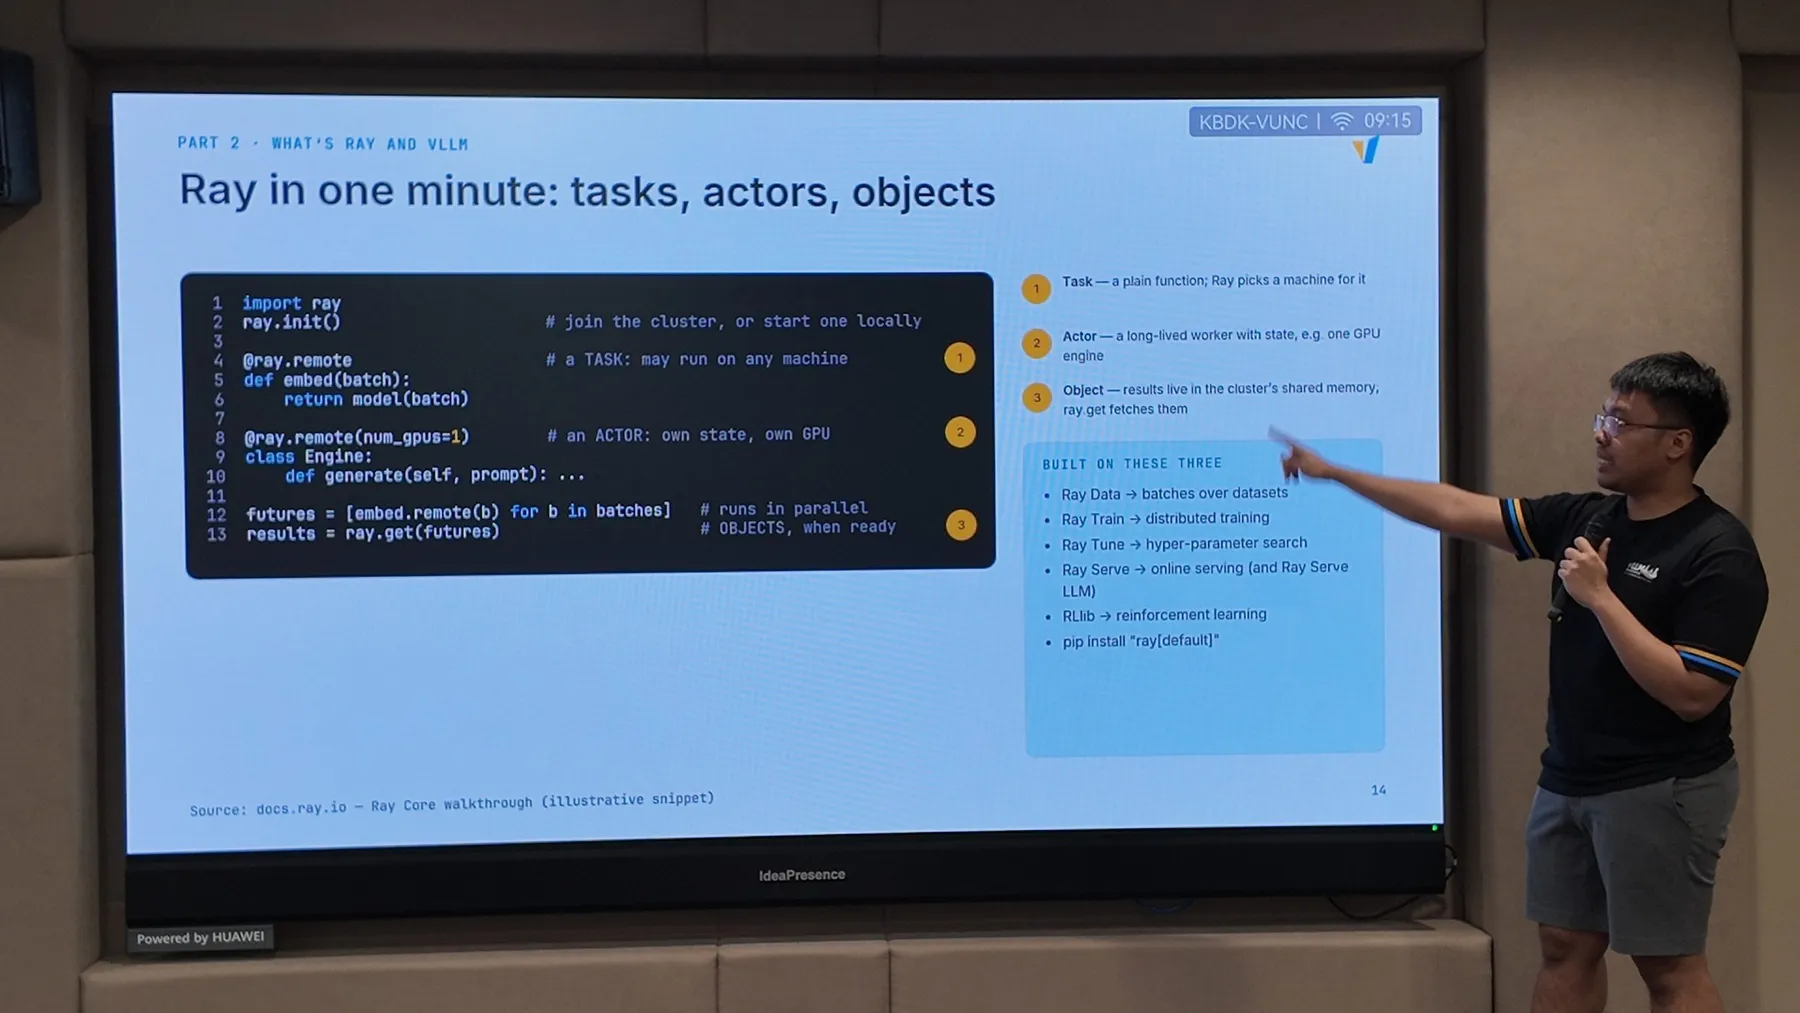
    • Ray สำหรับมือใหม่: รันโค้ด Python ธรรมดาบนหลายเครื่องเหมือนเป็นเครื่องเดียว, task, actor และ object, core เดียว พร้อมไลบรารีห้าตัว และ Anyscale บริษัทเบื้องหลัง Ray
    • vLLM คืออะไร ทำไม vLLM คือ engine ส่วน Ray คือ control plane, request หนึ่งรายการเดินทางผ่าน Ray Serve LLM อย่างไร และ API ทั้งหมดในสไลด์เดียว
    • ช่วงที่ 3 เล่าใหม่จาก Eyal Lantzman (Nscale): DeepSeek-V4-Flash พารามิเตอร์รวม 284B ทำงานจริง 13B พร้อม context window 1M token และ deployment shape สี่แบบที่ทดสอบ: TEP8, DP8xEP, prefill/decode disaggregation และ whole replicas
    • context ยาว ที่ cache คือหัวใจของต้นทุน: ส่ง KV จาก prefill ไป decode ผ่าน NIXL, fp8 KV คู่กับ block-size 256, fp4 indexer cache และ max-model-len ที่เป็นตัวปรับสมดุลระหว่าง context กับ throughput
    • ผลวัดจริงบน 8x B200 กับ vLLM v0.27.1: TEP8 แบบเรียบง่ายชนะ reference shape ที่เผยแพร่ไว้ 2,209 เทียบกับ 1,634 tok/s ที่ 32 คำขอพร้อมกัน, ต้องตรวจผลลัพธ์ด้วย ไม่ใช่ดูแค่ tok/s และล็อกเวอร์ชันของ engine ให้ตรงกับที่จะใช้จริง

    ลิงก์

  2. หัวข้อที่ 02 ·

    State of vLLM 2026

    Paphanin Amnuaikitwanit · AI Engineer · vLLM Bangkok

    เซสชันต้นฉบับ: Woosuk Kwon, Zachary Xi (Inferact)

    Paphanin Amnuaikitwanit (Toon) สรุปทอล์ก State of vLLM 2026 ของ Woosuk Kwon และ Zachary Xi มาเล่าต่อ: ทำไมการรัน inference เองถึงสำคัญในวันที่โมเดลเปิดออกมาไม่หยุด และสามเรื่องหลักที่โปรเจกต์โฟกัส — core redesign (Model Runner V2, asynchronous scheduling, Rust API server), model optimization (kernel fusion, composable parallelism, speculative decoding) และ agentic workloads (KV reuse, Mooncake, session-aware routing, cache eviction ที่ฉลาดขึ้น) — ปิดท้ายด้วยสิ่งที่จะมาต่อ

    เนื้อหาในสไลด์
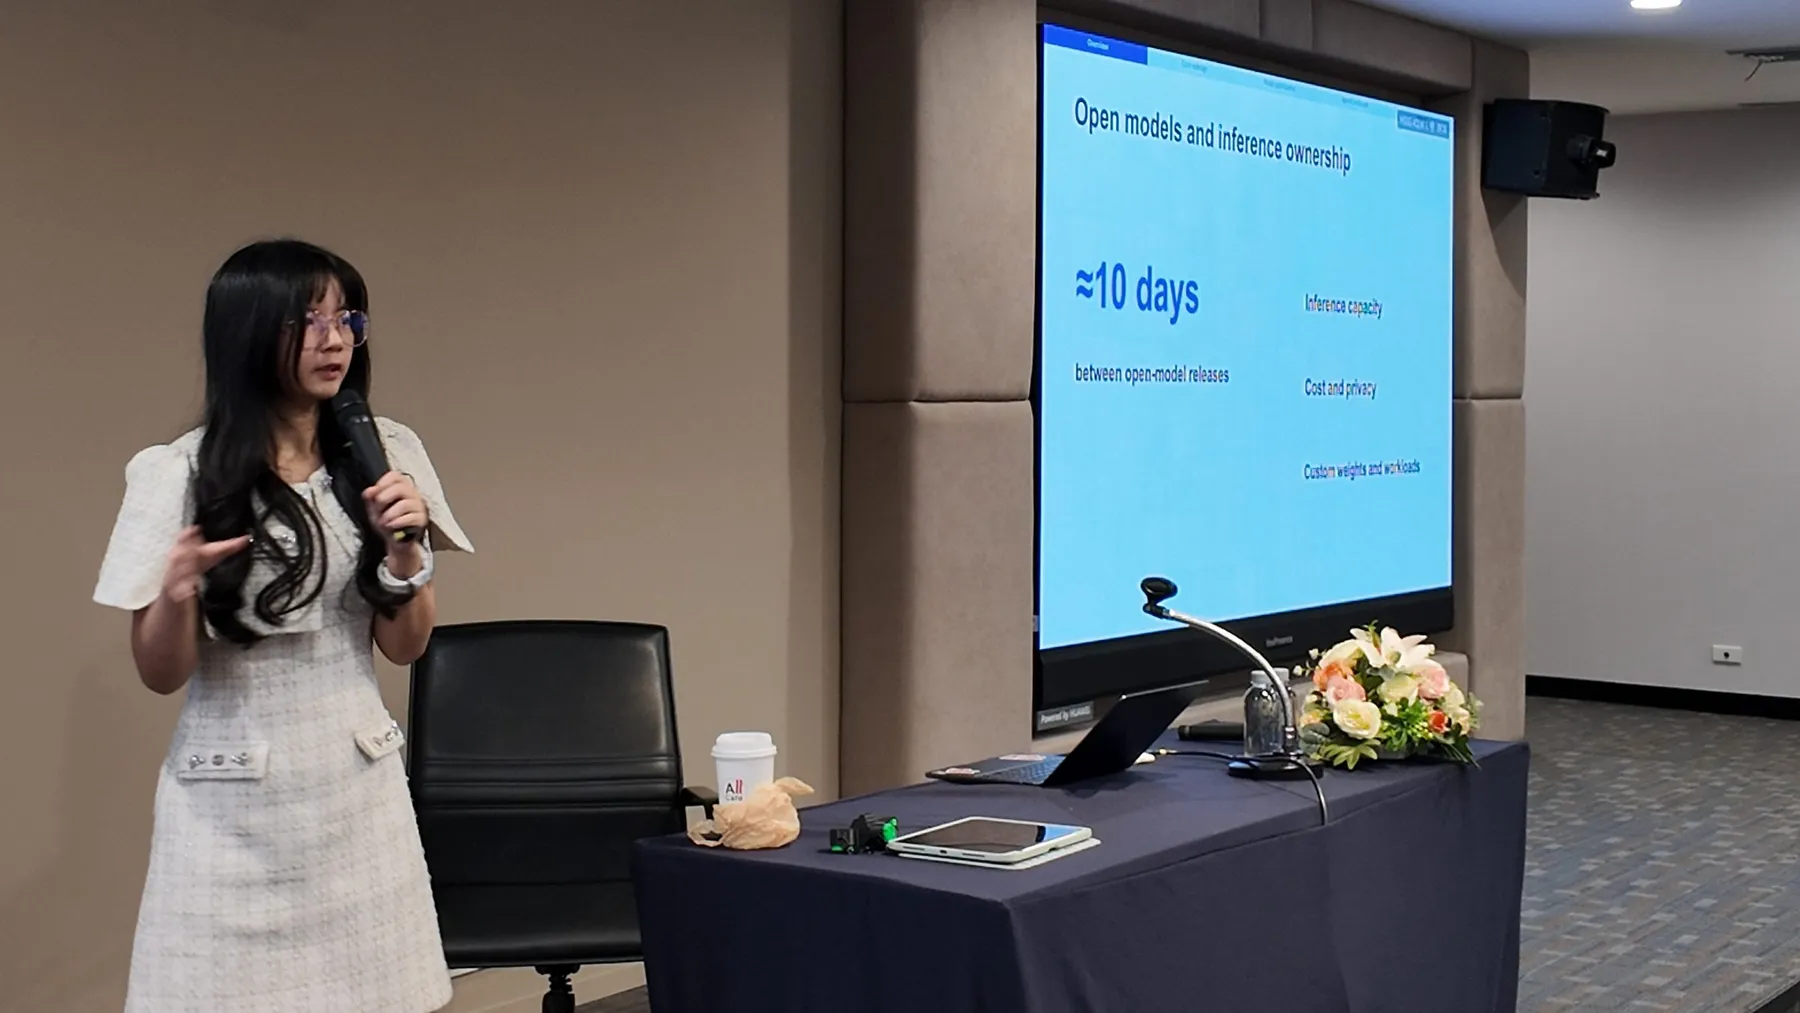
    • โมเดลเปิดกับการเป็นเจ้าของ inference เอง: โมเดลเปิดออกใหม่ห่างกันราว 10 วัน และ vLLM มี 89.7K stars บน GitHub กับผู้ร่วมพัฒนา 3,251 คน (GitHub, สิงหาคม 2026)
    • Core redesign: Model Runner V2 ย้ายงาน bookkeeping บางส่วนไปทำบน GPU (output จาก 16K เป็น 25K tok/s หรือ +56.2%) และ asynchronous scheduling ให้ CPU จัดคิวขั้นถัดไประหว่างที่ GPU ยังประมวลผลอยู่
    • ModelState API ที่รองรับทั้ง LLM ทั่วไป, diffusion LM และ Whisper, Rust API server ที่เริ่มทำงานใน ~7 ms และใช้หน่วยความจำสูงสุดไม่ถึง 100 MB ที่ 1400 concurrency และ KV cache layout มาตรฐานเดียวสำหรับ GQA, MLA, CSA และ KDA
    • Model optimization: ทำไมต้องมี GPU kernel เฉพาะทาง และการ fuse GEMM เข้ากับ reduce-scatter ให้การคำนวณกับการสื่อสารทำงานซ้อนกันได้
    • Parallelism: ทำไม tensor parallelism อย่างเดียวถึงไม่พอเสมอไปสำหรับโมเดลยุคใหม่ composable parallelism (TP, PP, DP, EP, SP, PCP, DCP) และ GLM-5.2 กับ prefill context parallelism ที่ได้ TTFT เร็วกว่า TP ~3.5x ในผลทดสอบที่รายงาน
    • Speculative decoding: Eagle, MTP, DFlash 1 & 2, DSpark และ RecoverSSM ใช้ร่วมกับ logprobs, structured outputs และ PD disaggregation ได้ พร้อมเชื่อมกับการฝึกผ่าน Speculators + TorchSpec
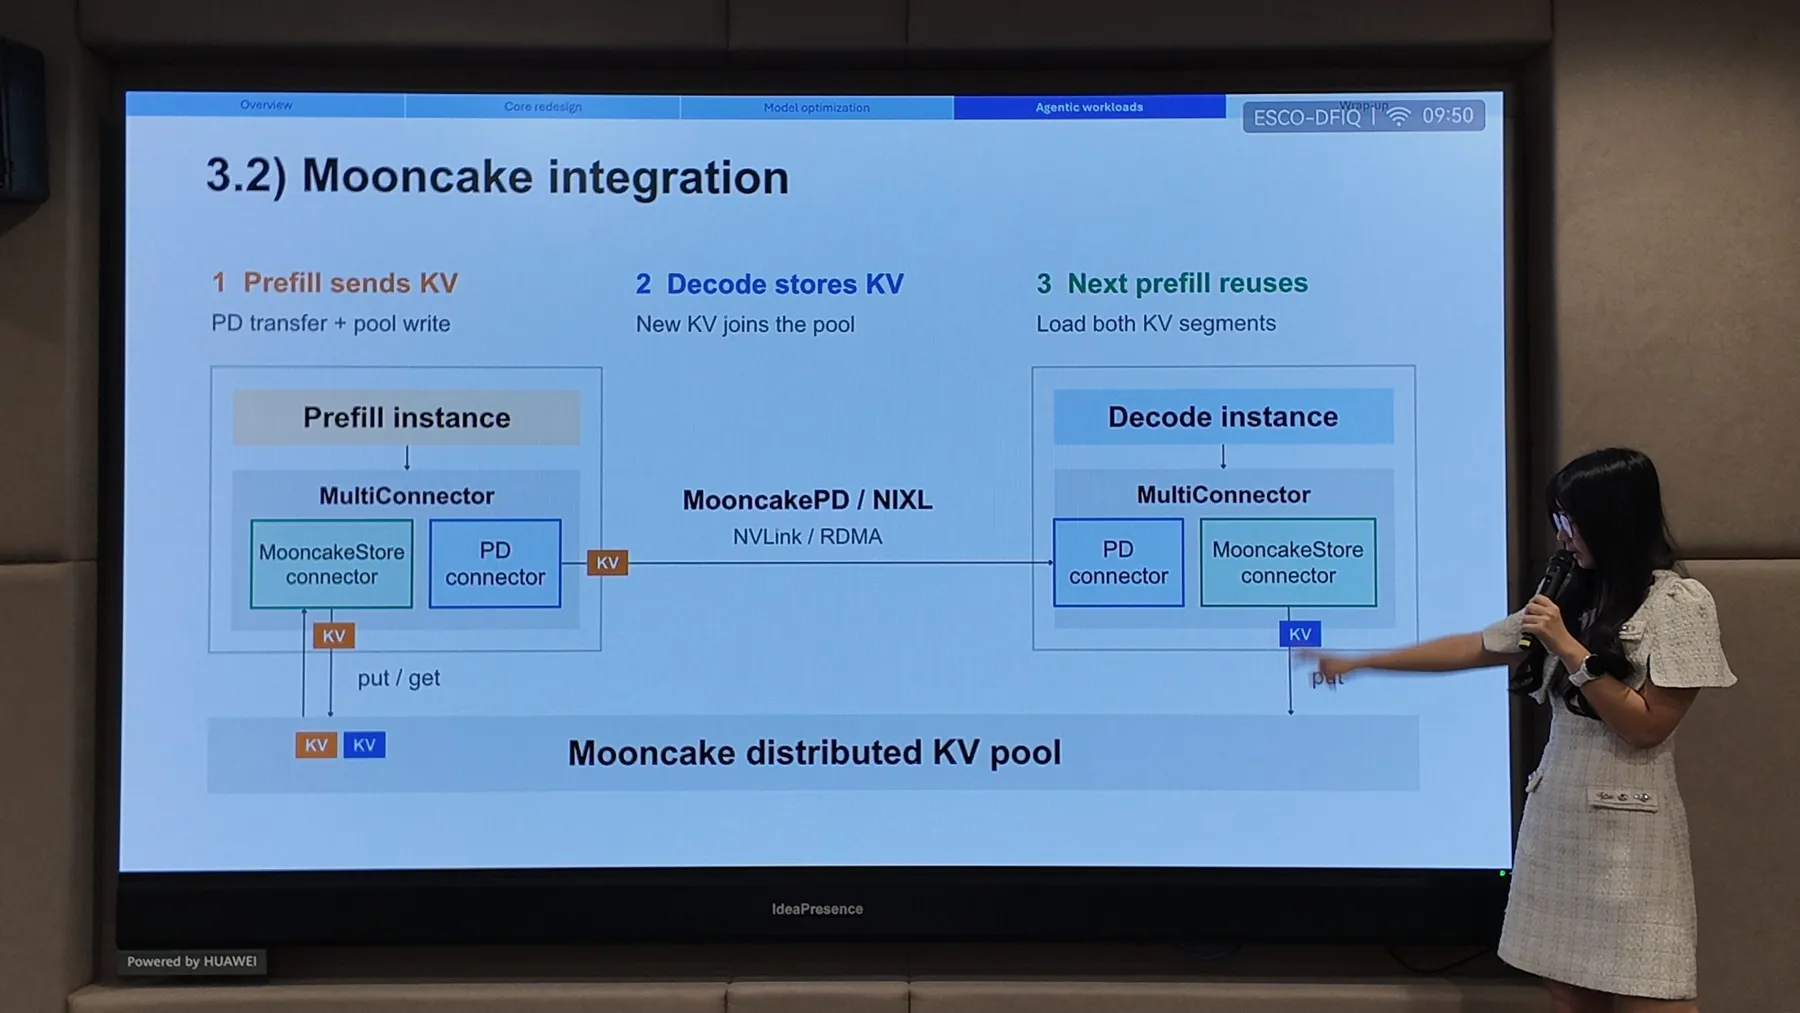
    • Agentic workloads: งานเดียวของผู้ใช้อาจต้อง inference หลายรอบ จึงมี multi-turn KV reuse, KV pool แบบกระจายของ Mooncake, session-aware routing (Dynamo, llm-d, SMG), cache eviction ที่ฉลาดขึ้น และ sparse retention
    • สิ่งที่จะมาต่อ: KV management API ที่ง่ายขึ้น, performance metrics และ models พร้อมเมตริกที่ละเอียดขึ้น, รองรับฮาร์ดแวร์กว้างขึ้น (AMD GPU, Google TPU) และการผสาน RL กับ multimodal

    ลิงก์

  3. หัวข้อที่ 03 ·

    Beyond Text-to-Video: Omni-Context Generation in a 33B Model

    Sattaya Singkul · Specialist Lead of AI Solution and Platform · True Digital Group

    MiniMax H3 โมเดล open weights ขนาด 33B ที่ครองอันดับ 1 ด้าน video editing สร้างวิดีโอและเสียงแบบ native ใน sequence เดียว แต่ทางเลือกนี้มีราคา: คลิป 10 วินาทีใช้เวลา 82.2 วินาทีบน 8x B300 Sattaya Singkul เริ่มจากเซสชัน H3 ของ MiniMax ใน Ray Summit 2026 แล้วพาดูว่าคอขวดแต่ละจุดถูกแก้ลงได้อย่างไร — precompute กับ quantization, Ulysses ที่กระจายงานข้าม GPU, runtime ของ vLLM-Omni, FastH3 ที่ใช้ distillation จนเหลือ 8.7 วินาที และ Ray Serve สำหรับรองรับผู้ใช้จำนวนมากพร้อมกัน

    เนื้อหาในสไลด์
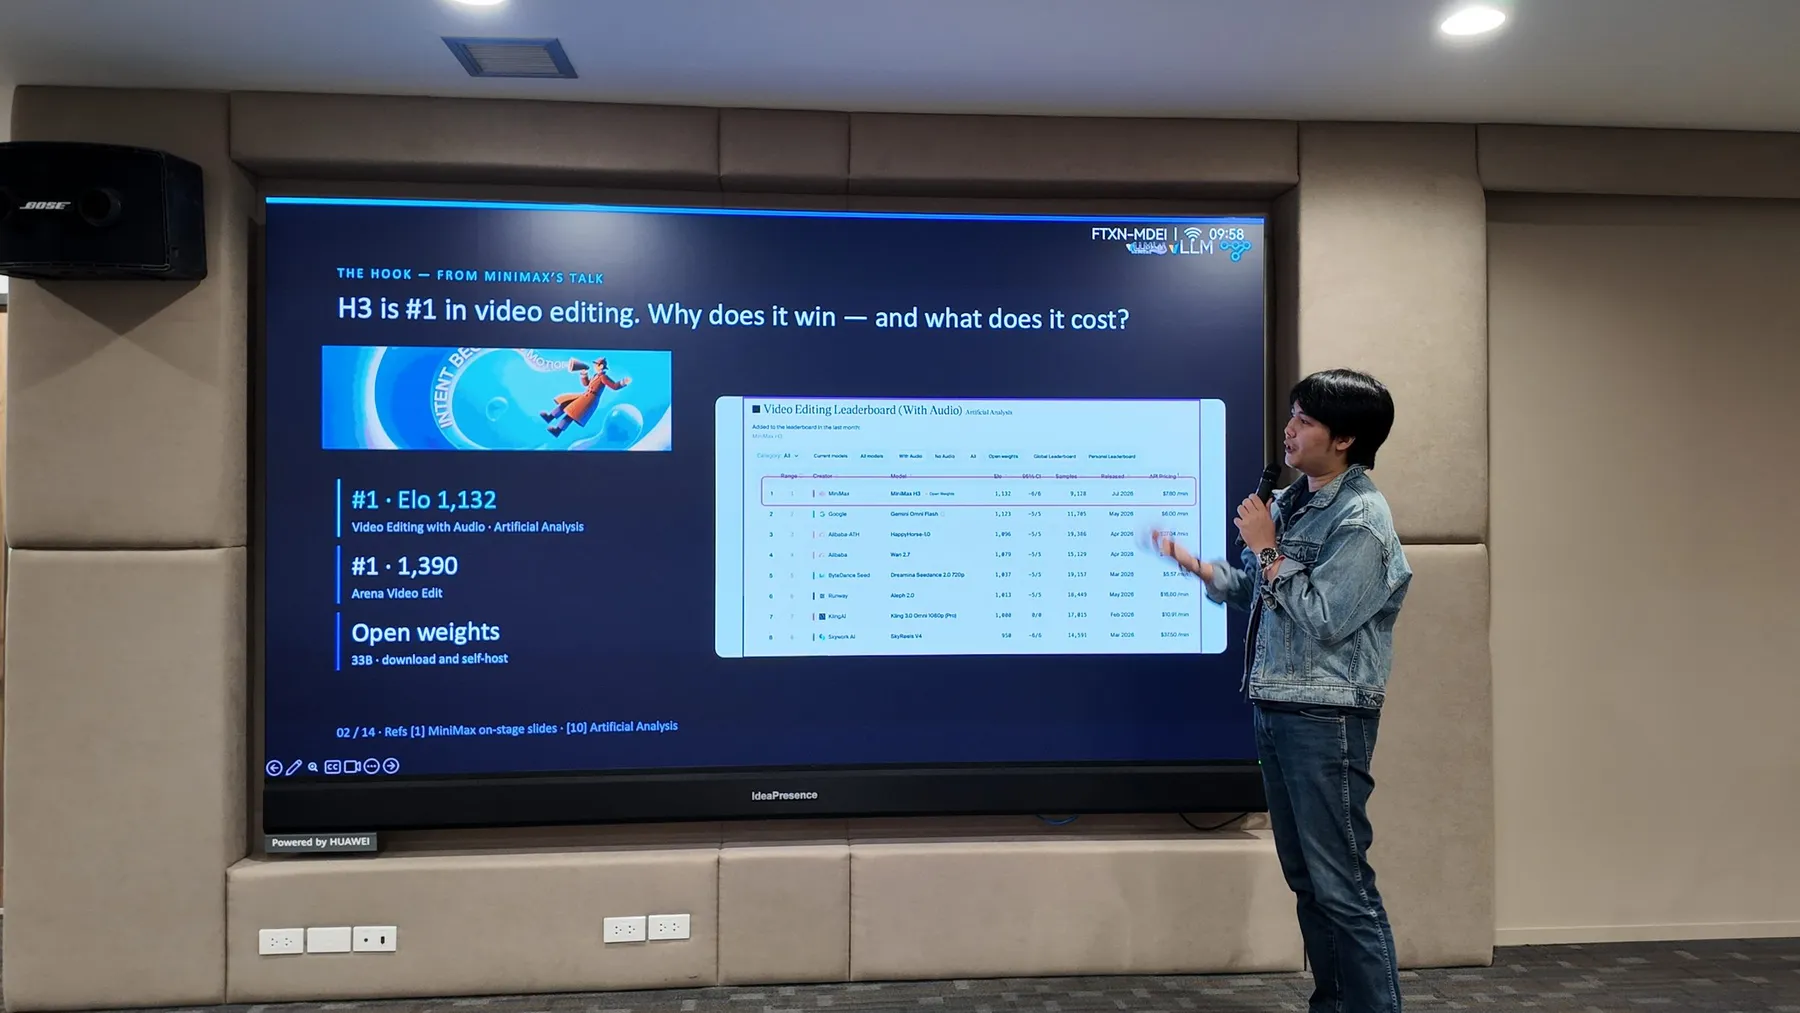
    • จุดเริ่มเรื่อง: H3 ครองอันดับ 1 ด้าน video editing (Elo 1,132 บน Artificial Analysis และ 1,390 บน Arena Video Edit) พร้อม weights ขนาด 33B ให้ดาวน์โหลดไป self-host ได้ — ทำไมถึงชนะ และต้องแลกด้วยอะไร
    • Act 1 ทางเลือก: multimodality ต้องเป็น native ไม่ใช่ประกอบจากหลายชิ้น — โมเดลเดียวรับทั้งข้อความ ภาพ วิดีโอ และเสียง แทนการต่อ T2V, TTS, lip-sync และ upscale เป็นทอด ๆ ระบบ H3 ประกอบด้วย Context-IR (ปิด), H3-Base ที่ 768p (open weights) และ Regenerate-2K (ปิด)
    • Act 2 ต้นทุน: H3-Base เข้ารหัส แพ็กทุกอย่างลงใน sequence เดียว สร้างด้วย Omni Transformer 33B แล้วถอดรหัส คลิป 10 วินาทีจึงใช้เวลา 82.2 วินาทีบน 8x B300 ใช้หน่วยความจำ ~128 GB, 58,758 tokens และ 49 denoise steps
    • แก้จุดที่ 1 หน่วยความจำ: เปลี่ยน AdaLN MLP เป็น lookup table ที่คำนวณไว้ล่วงหน้า และ quantize checkpoint จาก 123.6 GB (BF16) เหลือ ~42.5 GB (pruned INT8 + NVFP4) จนลงมาถึงการ์ด 16 GB
    • แก้จุดที่ 2 ความยาว sequence: Ulysses แบ่ง attention ของ 59K tokens ไปหลาย GPU (จำนวน GPU ต้องหาร 56 heads ลงตัว) เสริมด้วย layerwise offload (HBM ลดลง 37.5% แลกกับ latency เพิ่ม 5.1%) และแยก encoder ออกเป็นอีก stage
    • แก้จุดที่ 3 latency: runtime แบบ diffusion-native ของ vLLM-Omni ลดจาก 82.2 เหลือ 56.9 วินาทีแบบ lossless และ FastH3 ใช้ distillation (DMD2 + VSA) ลดจาก 49 steps เหลือ 4 ได้คลิป 10 วินาทีใน 8.7 วินาที เร็วกว่าเวลาเล่นจริง
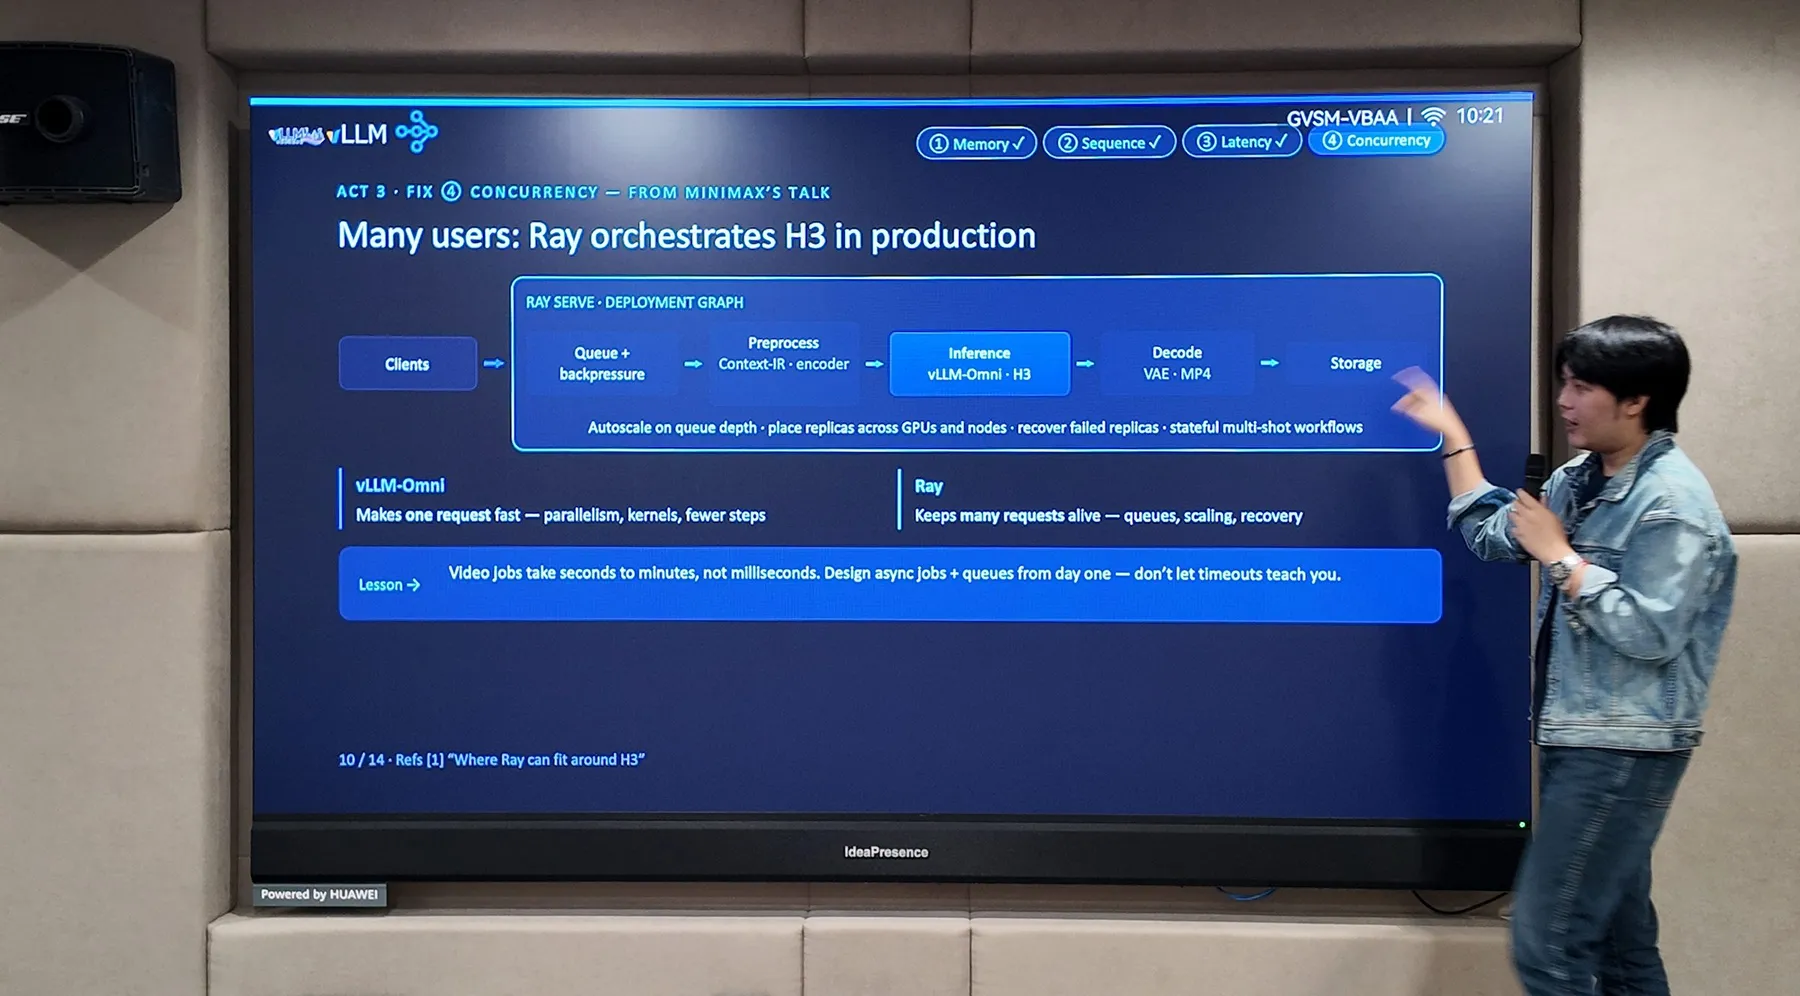
    • แก้จุดที่ 4 concurrency: Ray Serve รัน H3 เป็น deployment graph มีคิวกับ backpressure, autoscale ตามความยาวคิว และกู้ replica ที่ล้ม — vLLM-Omni ทำให้คำขอเดียวเร็ว ส่วน Ray ดูแลให้คำขอจำนวนมากไม่สะดุด
    • Act 4 ก่อนและหลัง: 82.2 เหลือ 8.7 วินาที, 123.6 GB เหลือ ~42.5 GB, 8 GPU เหลือการ์ด 16 GB (คนละรอบการทดสอบ จึงควรอ่านเป็นขนาดของการเปลี่ยนแปลง) และสามคำถามสำหรับโมเดลตัวถัดไปของคุณ: ทางเลือก ต้นทุน และวิธีแก้

    ลิงก์

  4. หัวข้อที่ 04 ·

    Accelerating Large Language Models: vLLM on TPUs

    Kanin Kearpimy · Fellow · Python Software Foundation

    เซสชันต้นฉบับ: Qi Zhou, Google

    vLLM รันบน Google TPU ได้อย่างไร Kanin Kearpimy ปูพื้นตั้งแต่หลักการ: CPU, GPU และ TPU คำนวณต่างกันอย่างไร (SISD, SIMD, SIMT และ systolic array ที่อยู่เบื้องหลัง Matrix Multiply Unit ของ TPU) สองแนวคิดที่ทำให้ vLLM เร็ว (continuous batching และ PagedAttention) และ software stack ของ TPU ตั้งแต่ TorchAX ซึ่งเป็น runtime ปัจจุบันของ vLLM บน TPU ไปจนถึง TorchTPU

    เนื้อหาในสไลด์
    • โปรเจกต์ vllm-project/tpu-inference: backend เดียวที่รองรับทั้ง PyTorch และ JAX บน TPU
    • ตลาดมี AI accelerator อยู่กี่แบบ นอกจาก TPU และ GPU ยังมีสตาร์ทอัพ 50+ รายที่กำลังสร้างชิปของตัวเอง
    • scalar, vector, matrix และ tensor กับวิธีที่ฮาร์ดแวร์คำนวณ: SISD บน CPU (ติดคอขวดที่หน่วยความจำ), SIMD ด้วย vector register และ SIMT ที่กระจายงานไปหลาย thread บน GPU
    • tensor ขนาดใหญ่: แก่นของ neural network คือการคูณ input ด้วย weight
    • ภายใน TPU: processing element ที่เรียงกันเป็น systolic array ประกอบเป็น Matrix Multiply Unit (MXU) โดยรับข้อมูลจาก host memory, DRAM และ unified memory (SRAM)
    • vLLM ทำงานอย่างไร: continuous batching ใช้พลังประมวลผลของ GPU ได้ ~100% และ PagedAttention ลด memory fragmentation ให้เหลือเพียงส่วนน้อย
    • การเขียนโปรแกรมบน TPU: TorchAX ซึ่งเป็น runtime ปัจจุบันของ vLLM บน TPU ต้องผ่าน JAX ส่วน TorchTPU ไปจาก PyTorch ตรงสู่ StableHLO และ graph IR (XLA) คอมไพล์เร็วขึ้น และความเร็วดีขึ้นเป็นกรณีไป
    • ข้อคิดสำคัญ: vLLM รันบน TPU ได้มานานแล้ว ไม่มี accelerator ไหนเป็นยาวิเศษ ทั้ง GPU, TPU และ CPU และเรากำลังมุ่งสู่ระบบแบบ heterogeneous ส่วน TorchTPU ก็มาถึงแล้วสำหรับ vLLM บน TPU

    ลิงก์

  5. หัวข้อที่ 05 ·

    AMD and vLLM: What’s New

    Passin Pornvoraphat · PhD Candidate · Chulalongkorn University

    เซสชันต้นฉบับ: Douglas Lehr, AMD

    ปี 2026 AMD ย้ายงาน vLLM จาก fork ไปทำใน upstream Passin Pornvoraphat เล่าต่อจากเซสชัน AMD and vLLM: What’s New ที่ Douglas Lehr จาก AMD บรรยายในงาน vLLM Conference ครั้งแรกภายใน Ray Summit 2026 ว่าการย้ายครั้งนี้เปลี่ยนอะไรบ้าง: PR ของ AMD และ ROCm ที่ merge แล้ว 1,041 รายการในหนึ่งปี (14.2% ของ PR ทั้งหมดของ vLLM ในเดือน ก.ค. 2026) เครื่อง CI ที่เพิ่มจาก 29 เป็น 128 node เส้นทางของ kernel จาก FlyDSL ผ่าน AITER และ ATOM เข้าสู่ vLLM, Quark และ TraceLens, vLLM บน Radeon และสิ่งที่กำลังจะมา

    เนื้อหาในสไลด์
    • AMD ใน vLLM วันนี้ ช่วง ส.ค. 2025 ถึง ก.ค. 2026: PR ของ AMD และ ROCm ที่ merge แล้ว 1,041 รายการจากผู้เขียน 174 คน โดย 73% เขียนโดยวิศวกรของ AMD, PR ของ ROCm ต่อเดือนเพิ่มจาก 25 เป็น 163 คิดเป็น 14.2% ของ PR ทั้งหมดของ vLLM ในเดือน ก.ค. 2026, วิศวกร AMD 48 คนส่งงานเข้า vLLM เป็นครั้งแรกในปีนี้ และมี code owner ฝั่ง AMD 5 คน
    • 2026 ปีที่ AMD ย้ายไป upstream: เลิกใช้ fork ROCm/vllm (พ.ย. 2023 ถึง ก.ย. 2025) แล้ว vLLM เป็นผู้ build และปล่อย wheel ของ ROCm และ image vllm/vllm-openai-rocm เอง ค่าตั้งของโมเดลอยู่ใน vllm-project/recipes และการแก้โค้ดส่งเข้า upstream ก่อนเสมอ
    • CI ของ AMD ใน vLLM: test group เพิ่มจาก 96 เป็น 193 โดย 73 กลุ่มกั้นการ merge, เวลา build Docker ต่อ PR ลดจาก 40 เหลือ 5 นาที, อัตราผ่านการทดสอบของ AMD จาก 63.9% ในเดือน พ.ค. เป็น 100% ในเดือน ส.ค. และเครื่อง CI บน GPU Instinct เพิ่มจาก 29 เป็น 128 node
    • GPU ตระกูล Instinct ตั้งแต่ MI250 ถึง MI450 ความเร็วและต้นทุนต่อ token เทียบกับ NVIDIA บน DeepSeek R1 (SemiAnalysis InferenceX) และ Day 0 support: โมเดลใหม่รันบน ROCm ได้ในวันเปิดตัว และ MI450 (gfx1250) รองรับใน upstream แล้ว
    • เส้นทางของ kernel ถึงผู้ใช้: เขียนด้วย FlyDSL (DSL ภาษา Python ที่มี MLIR compiler อยู่เบื้องหลัง merge แล้ว 24 PR และรอตรวจอีก 28), assembly, Triton หรือ Composable Kernel รวมไว้ใน AITER ที่เลือกตัวที่เร็วที่สุดให้ ทดสอบความเร็วใน ATOM แล้วส่งเข้า vLLM upstream ส่วน MoRI-IO ส่ง KV cache สำหรับ prefill/decode disaggregation และ ATOM ใช้เป็น plugin ของ vLLM ได้โดยไม่ต้องแก้ core
    • เครื่องมือ: Quark สำหรับ quantization (MXFP4, MXFP6 และ MXFP8 อยู่ใน upstream แล้ว, NVFP4 แบบ emulation บน MI300 และ MI355X และ KV cache 4 bit ด้วย TurboQuant), TraceLens ดูว่าเวลาใน trace หมดไปกับอะไร และ NIXL ที่ผู้ผลิตสองรายใช้ร่วมกันหลัง AMD ปิด fork RIXL
    • vLLM บน Navi: ตั้งแต่โน้ตบุ๊กและ mini PC ที่ใช้ Ryzen AI (unified memory ถึง 128 GB บน Ryzen AI Halo) ไปจนถึงเครื่องตั้งโต๊ะ Radeon 7000 และ 9000 และเซิร์ฟเวอร์ 1 ถึง 8 GPU โดย RDNA3 และ RDNA4 ใช้ vLLM ต้นฉบับได้เลย
    • สิ่งที่กำลังจะมา: ติดตั้ง ROCm ผ่าน pip install vllm ด้วย TheRock, Mooncake เป็นอีกทางเลือกในการส่งข้อมูลสำหรับ prefill/decode และ batch invariance ปิดท้ายด้วย repo ที่แนะนำ และห้อง #sig-amd บน Slack ของ vLLM

    ลิงก์

  6. หัวข้อที่ 06 ·

    NVIDIA and vLLM Full-Stack Collaboration for MoE Model Performance

    Arisa Umparat · AI Engineer & NLP Researcher · Ascend Group

    เซสชันต้นฉบับ: Siyuan Fu, NVIDIA

    GPU ที่แรงที่สุดอย่างเดียวไม่ได้ทำให้โมเดล Mixture of Experts ตอบได้เร็วเสมอไป Arisa Umparat เล่าทอล์กของ Siyuan Fu จาก NVIDIA ในงาน Ray Summit ไล่ bottleneck ทั้งสี่ระดับพร้อมวิธีแก้แต่ละจุด: kernel fusion ด้วย FlashInfer สำหรับ Kimi K3 (จาก 72 เป็น 111 tokens/sec), one-shot all-reduce สำหรับ MiniMax M2.5 (latency ลดลง 52%), prefill/decode disaggregation สำหรับ DeepSeek R1 บน GB200 NVL72 (10,000 tokens/sec ต่อ GPU) และ NVIDIA Dynamo ที่กระจายคำขอโดยดู KV cache ทั้งคลัสเตอร์

    เนื้อหาในสไลด์
    • ใช้ GPU ที่แรงที่สุดแล้วพอไหม ไม่เสมอไป โดยเฉพาะกับโมเดล Mixture of Experts: router ส่งแต่ละ token ไปหา expert อย่างไร และการแบ่งโมเดลข้าม GPU ด้วย tensor parallelism (TP) หรือ expert parallelism (EP)
    • คอมมูนิตี้โอเพนซอร์ส NVIDIA x vLLM: ผู้ร่วมพัฒนา vLLM จาก NVIDIA กว่า 60 คน PR ที่ merge แล้วกว่า 110 รายการในช่วง 3 เดือนที่ผ่านมา และ Day 0 support ให้โมเดลแล้ว 12 ตัว
    • bottleneck สี่ระดับจากเล็กไปใหญ่: การคำนวณใน kernel, การสื่อสารข้าม GPU, หน่วยความจำและฮาร์ดแวร์ และการจัดการทั้งระบบ พร้อม full-stack optimization matrix ที่จับคู่แต่ละระดับกับโมเดลและวิธีแก้
    • Kimi K3 กับ latent MoE บน GB300 (TP8): รวม collective ช่วง MoE tail ด้วย FlashInfer โดยแยก all-reduce ทำ communication ซ้อนกับ compute และรวม all-gather เข้ากับ GEMM เวลา MoE tail ลดลงราว 19.5% และความเร็วเพิ่มจาก 72 เป็น 111 tokens/sec
    • MiniMax M2.5 กับ full-heads RMSNorm: ข้อมูลเล็กแต่ต้องรอซิงก์นาน ใช้ one-shot all-reduce ลดจุดรอจาก 2 barrier เหลือ 1 จาก 15.5 µs เหลือ 7.4 µs (latency ลดลง 52%) โดย FlashInfer เลือก one-shot เมื่อ batch size ต่ำกว่า 40 และใช้ two-shot ในกรณีอื่น
    • DeepSeek R1 กับ PD disaggregation บน GB200 NVL72: quantize เป็น NVFP4 ก่อน all-gather ลด traffic บนเครือข่ายได้ 4 เท่า, V2 weight offloader ลด prefill จาก EP4 เหลือ EP2 และ prefill worker (EP2) 4 ตัวต่อ decode worker หนึ่งตัว (EP8) ได้ 10,000 tokens/sec ต่อ GPU
    • ข้อคิดที่นำไปใช้ได้: แยก all-reduce เป็น reduce-scatter กับ all-gather แล้วซ่อน latency ของแต่ละส่วน, รวม all-gather เข้ากับ GEMM, ใช้ one-shot all-reduce kernel เมื่อ traffic น้อย และใช้ parallel size ที่เล็กลงใน prefill worker
    • NVIDIA Dynamo สำหรับ distributed serving: ประสานคำขอระหว่าง worker ของ vLLM, SGLang หรือ TensorRT-LLM บน Kubernetes, KV-aware router ที่ชั่งระหว่าง prefix match กับ load, NIXL ส่ง KV cache, fault tolerance, ผล InferenceX บน NVL72 และ roadmap ของ Dynamo 2.0

    ลิงก์

กำหนดการและรายละเอียดงาน

ภาพบรรยากาศ

ภาพบรรยากาศในงาน ตั้งแต่เปิดงานจนถึงภาพหมู่

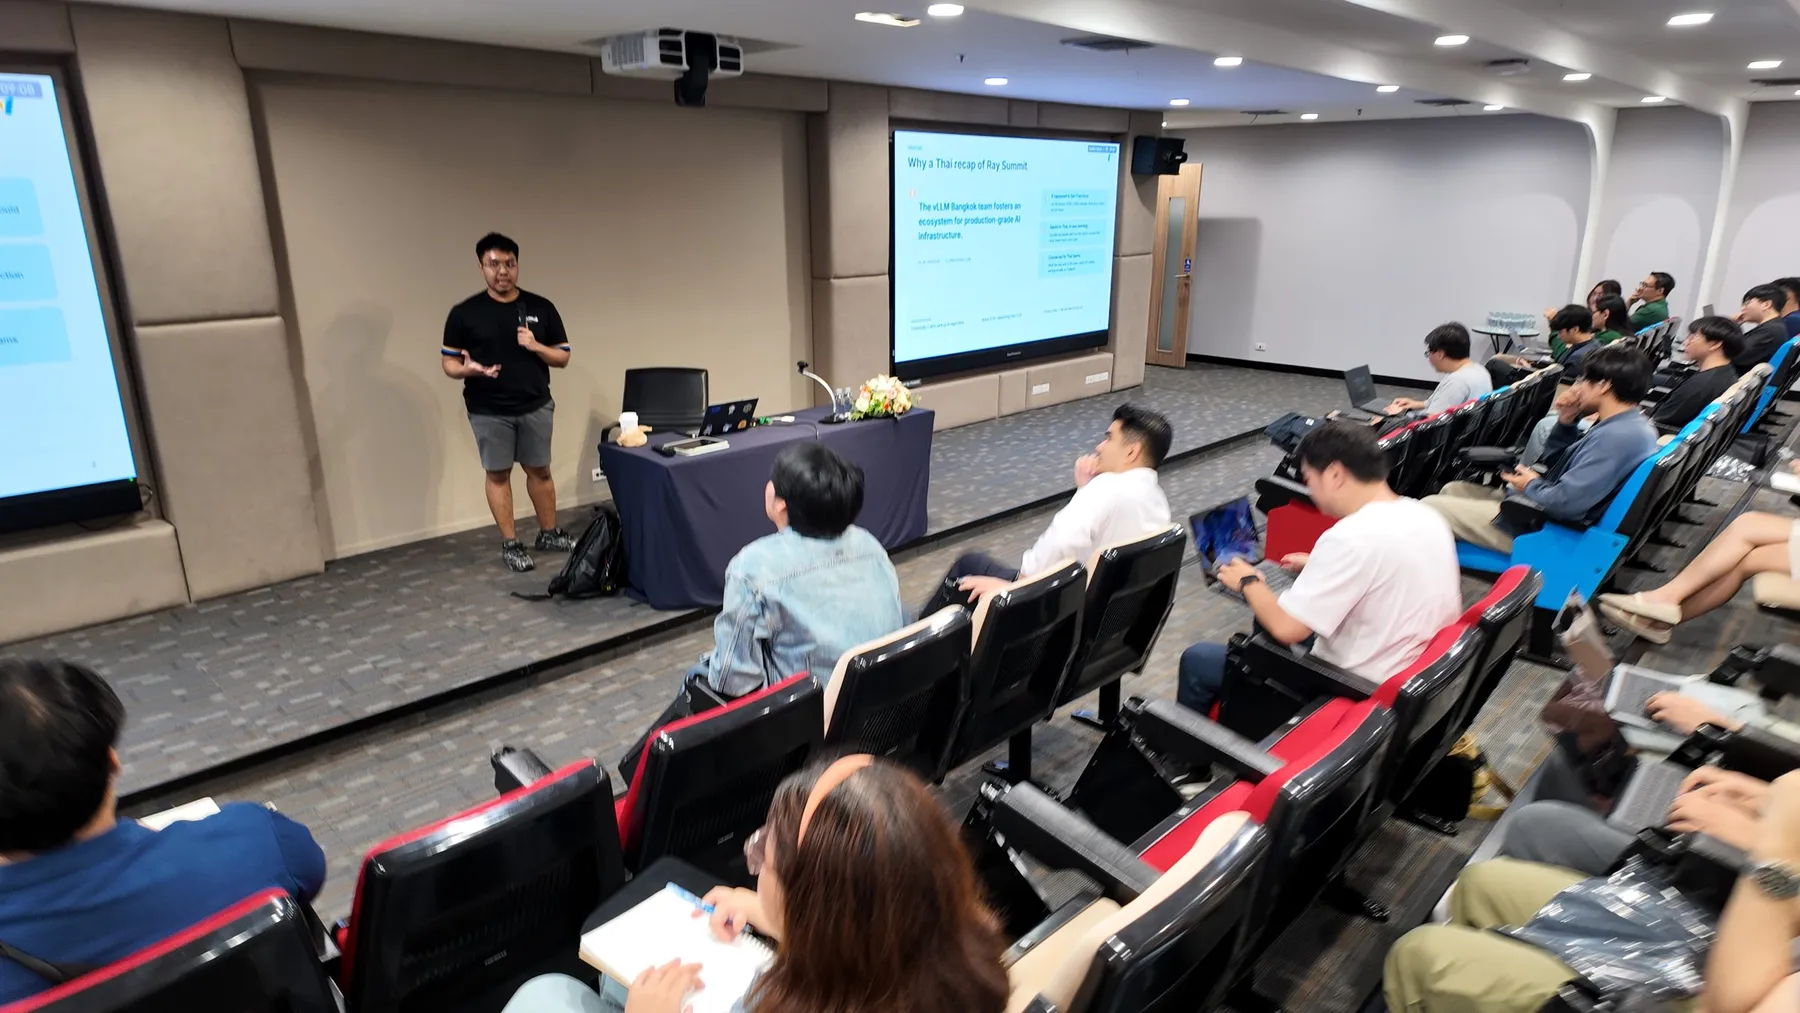
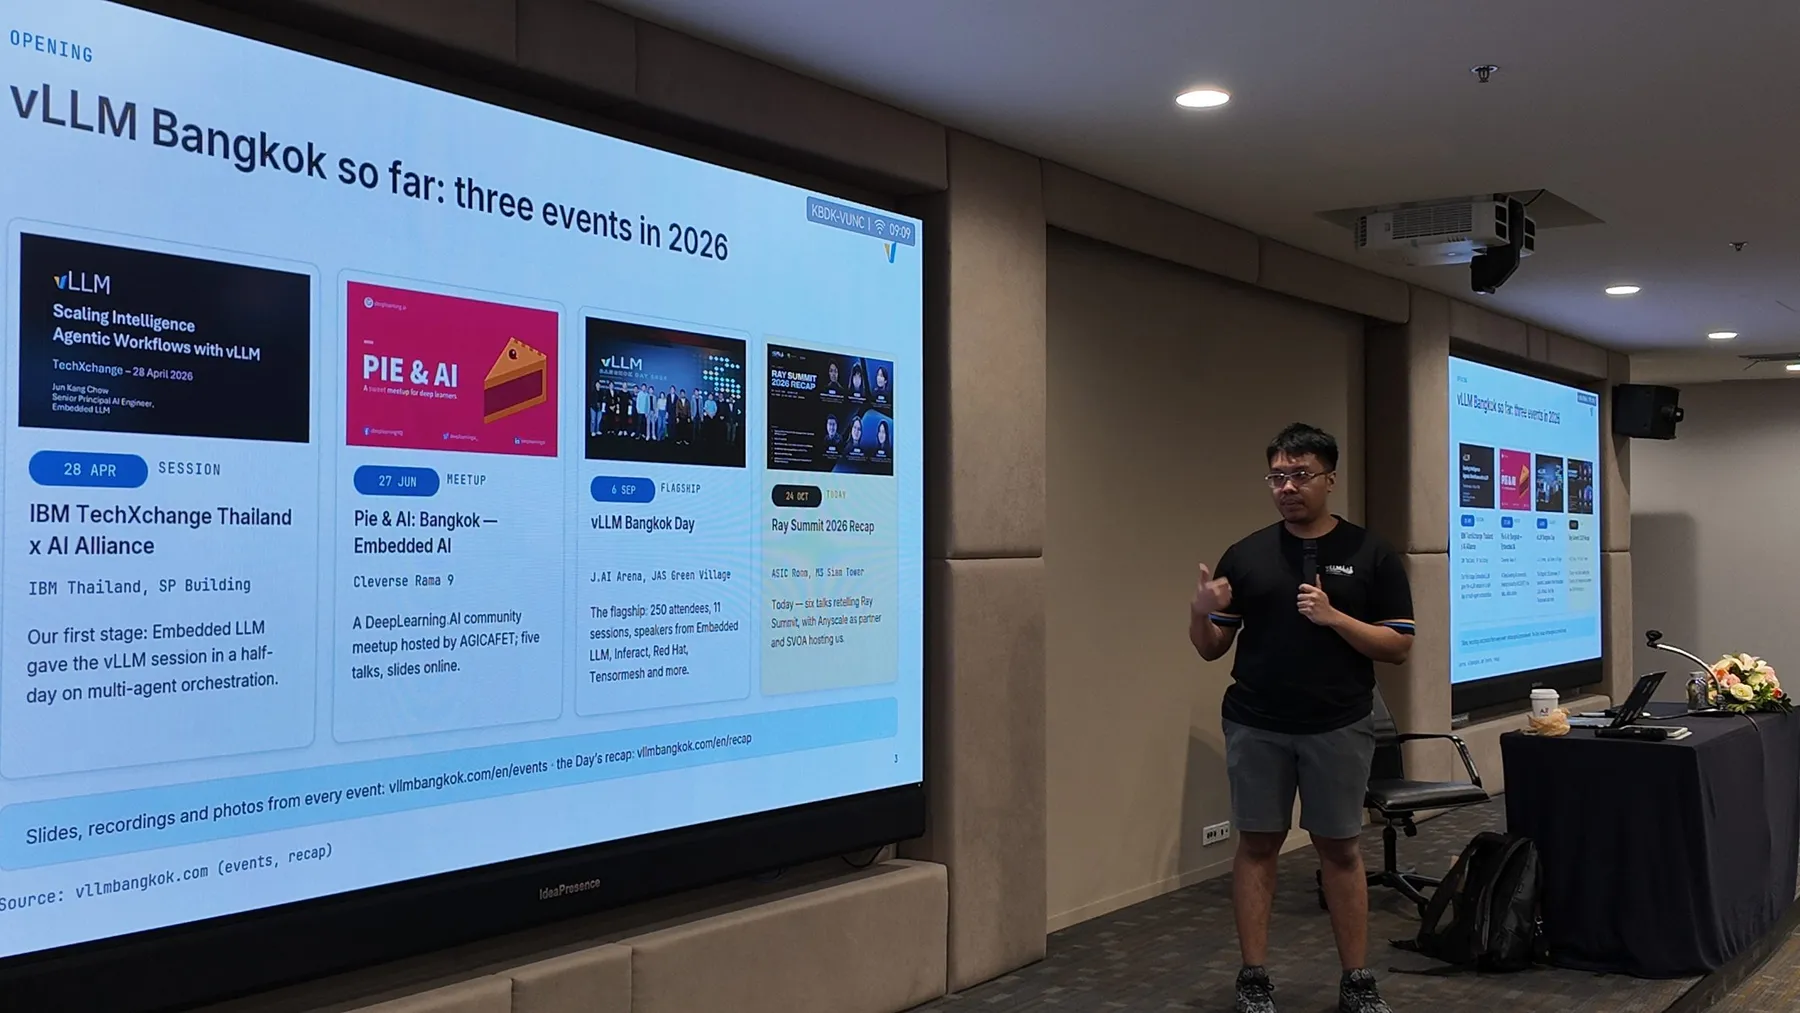
Natdhanai Praneenatthavee (Job) เปิดงาน Ray Summit 2026 Recap ที่ห้อง ASIC ข้างสไลด์ “Why a Thai recap of Ray Summit” โดยมีผู้ฟังนั่งอยู่ด้านหน้า
  • Natdhanai Praneenatthavee (Job) เล่าย้อนกิจกรรมของ vLLM Bangkok ในปี 2026 ตั้งแต่ IBM TechXchange ในเดือนเมษายนจนถึงงานสรุปครั้งนี้
  • Natdhanai Praneenatthavee (Job) ชี้สไลด์ “Ray in one minute: tasks, actors, objects” ที่อธิบายแนวคิดหลักของ Ray ด้วยตัวอย่างโค้ดสั้น ๆ
  • Paphanin Amnuaikitwanit (Toon) เริ่มหัวข้อ State of vLLM 2026 ด้วยสไลด์เรื่องโมเดลเปิดและการเป็นเจ้าของ inference เอง
  • Paphanin Amnuaikitwanit (Toon) ชี้แผนภาพการเชื่อมต่อ Mooncake กับ vLLM และ KV cache pool แบบกระจาย
  • Sattaya Singkul (Jo) อธิบายว่าทำไม MiniMax H3 ขึ้นอันดับหนึ่งด้านการตัดต่อวิดีโอ ในหัวข้อ Beyond Text-to-Video
  • Sattaya Singkul (Jo) อธิบายการใช้ Ray Serve ให้บริการ MiniMax H3 บนระบบจริงสำหรับผู้ใช้จำนวนมากพร้อมกัน ตั้งแต่คิวคำขอจนถึง vLLM-Omni
  • Kanin Kearpimy (James) บรรยายที่โต๊ะผู้บรรยายในหัวข้อ vLLM บน TPU
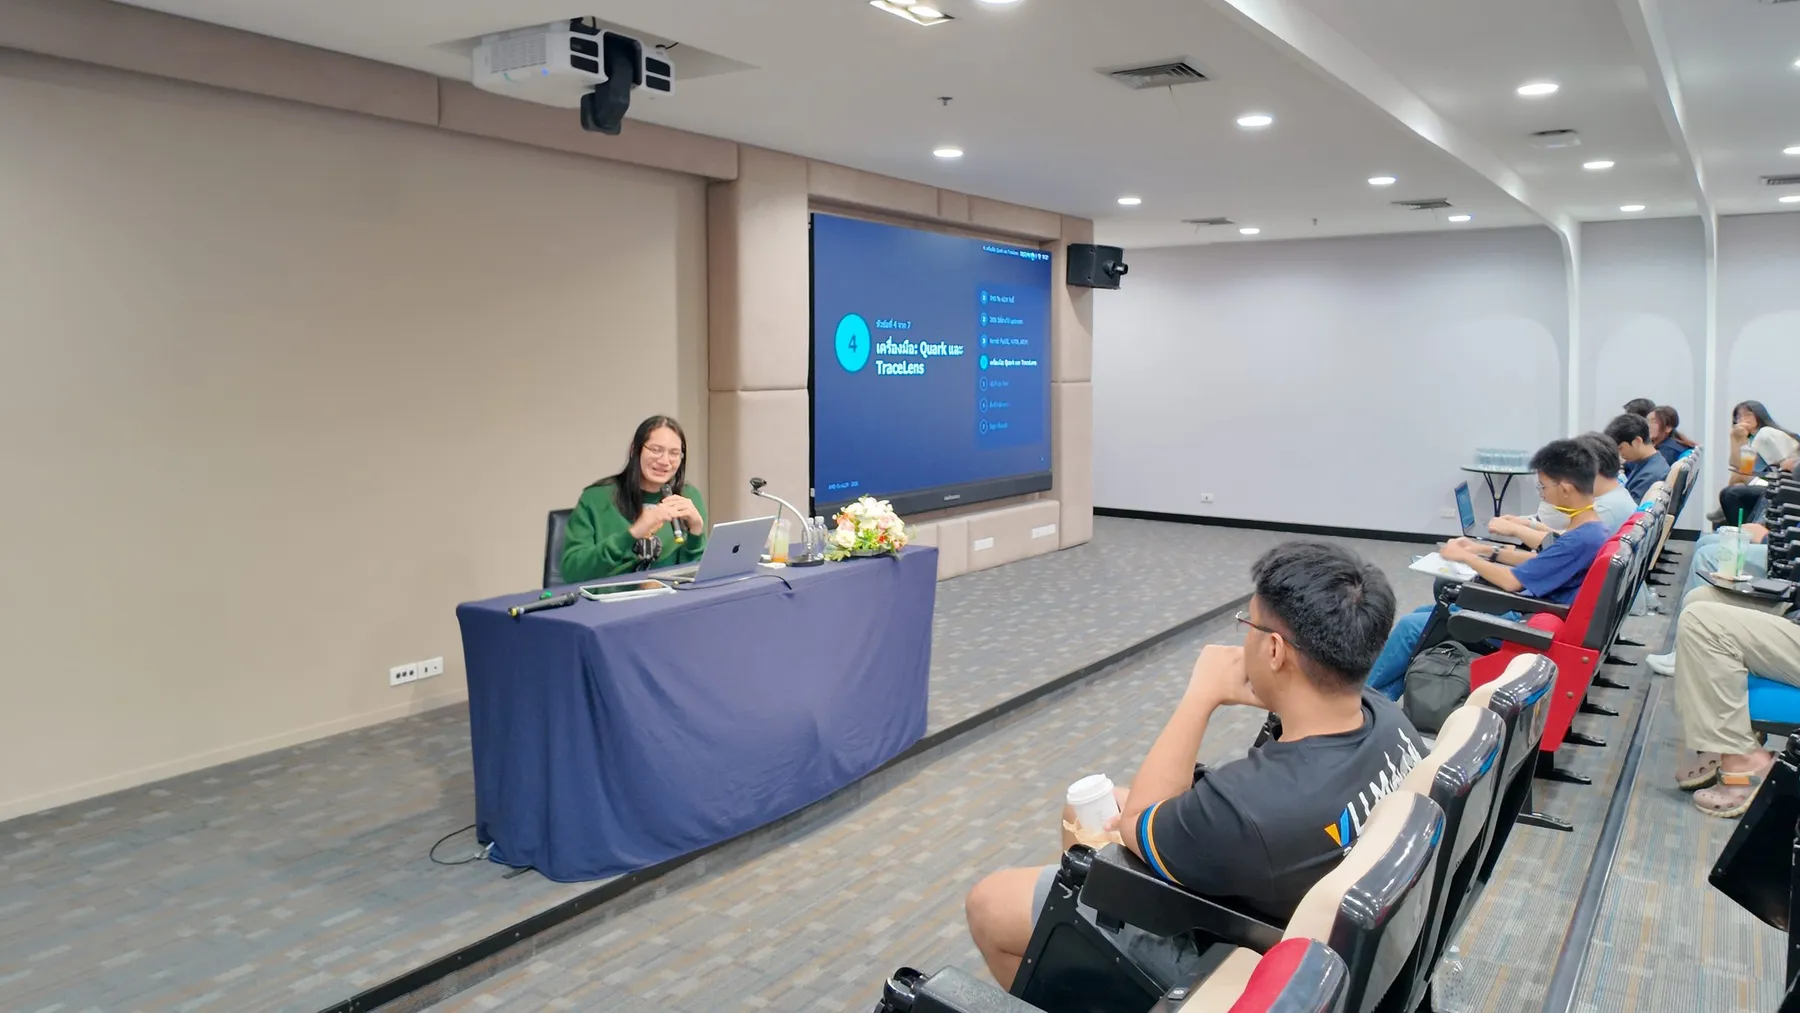
  • ภาพมุมกว้างของห้อง ASIC ขณะ Passin Pornvoraphat บรรยายหัวข้อ AMD กับ vLLM ช่วงเครื่องมือ Quark และ TraceLens
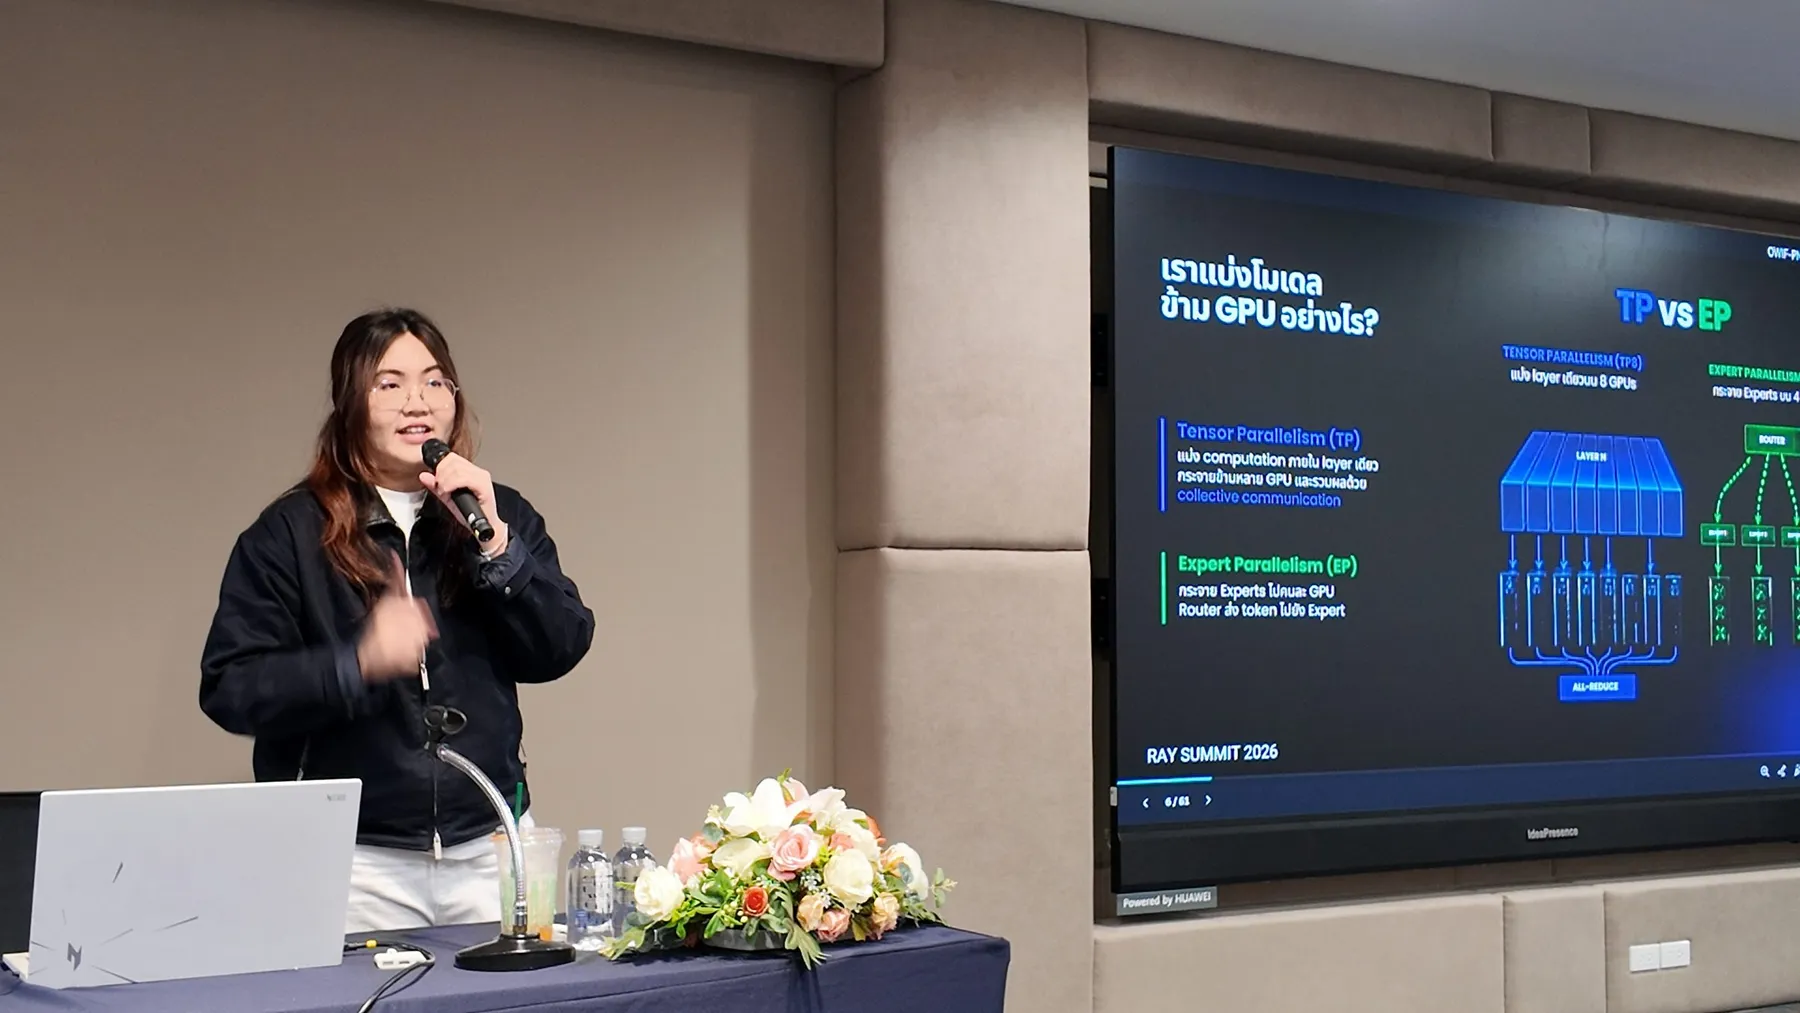
  • Arisa Umparat เปรียบเทียบ tensor parallelism กับ expert parallelism ในการแบ่งโมเดลไปรันบนหลาย GPU ในหัวข้อ NVIDIA กับ vLLM
  • สไลด์ขอบคุณ SVOA ผู้สนับสนุนสถานที่ในช่วงเปิดงาน พร้อมโลโก้ผู้จัด vLLM Bangkok และ AGICAFET และพาร์ตเนอร์ Anyscale
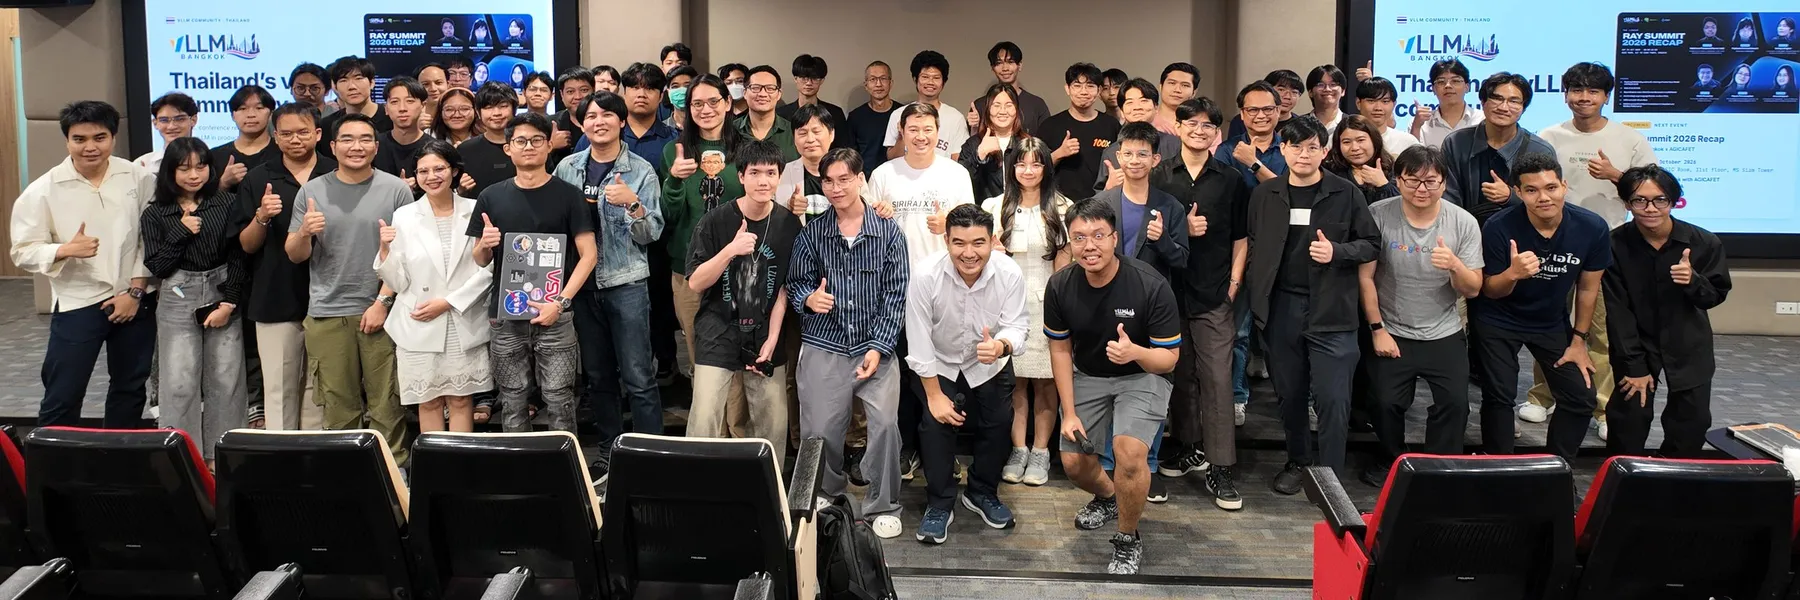
  • ผู้เข้าร่วม สปีกเกอร์ และทีมผู้จัดงาน Ray Summit 2026 Recap ชูนิ้วโป้งถ่ายภาพหมู่

เซสชัน vLLM จากงานอื่น ๆ ในไทย

meetup และเซสชันจากงานอื่น ๆ พร้อมสไลด์

ดูงานทั้งหมด →
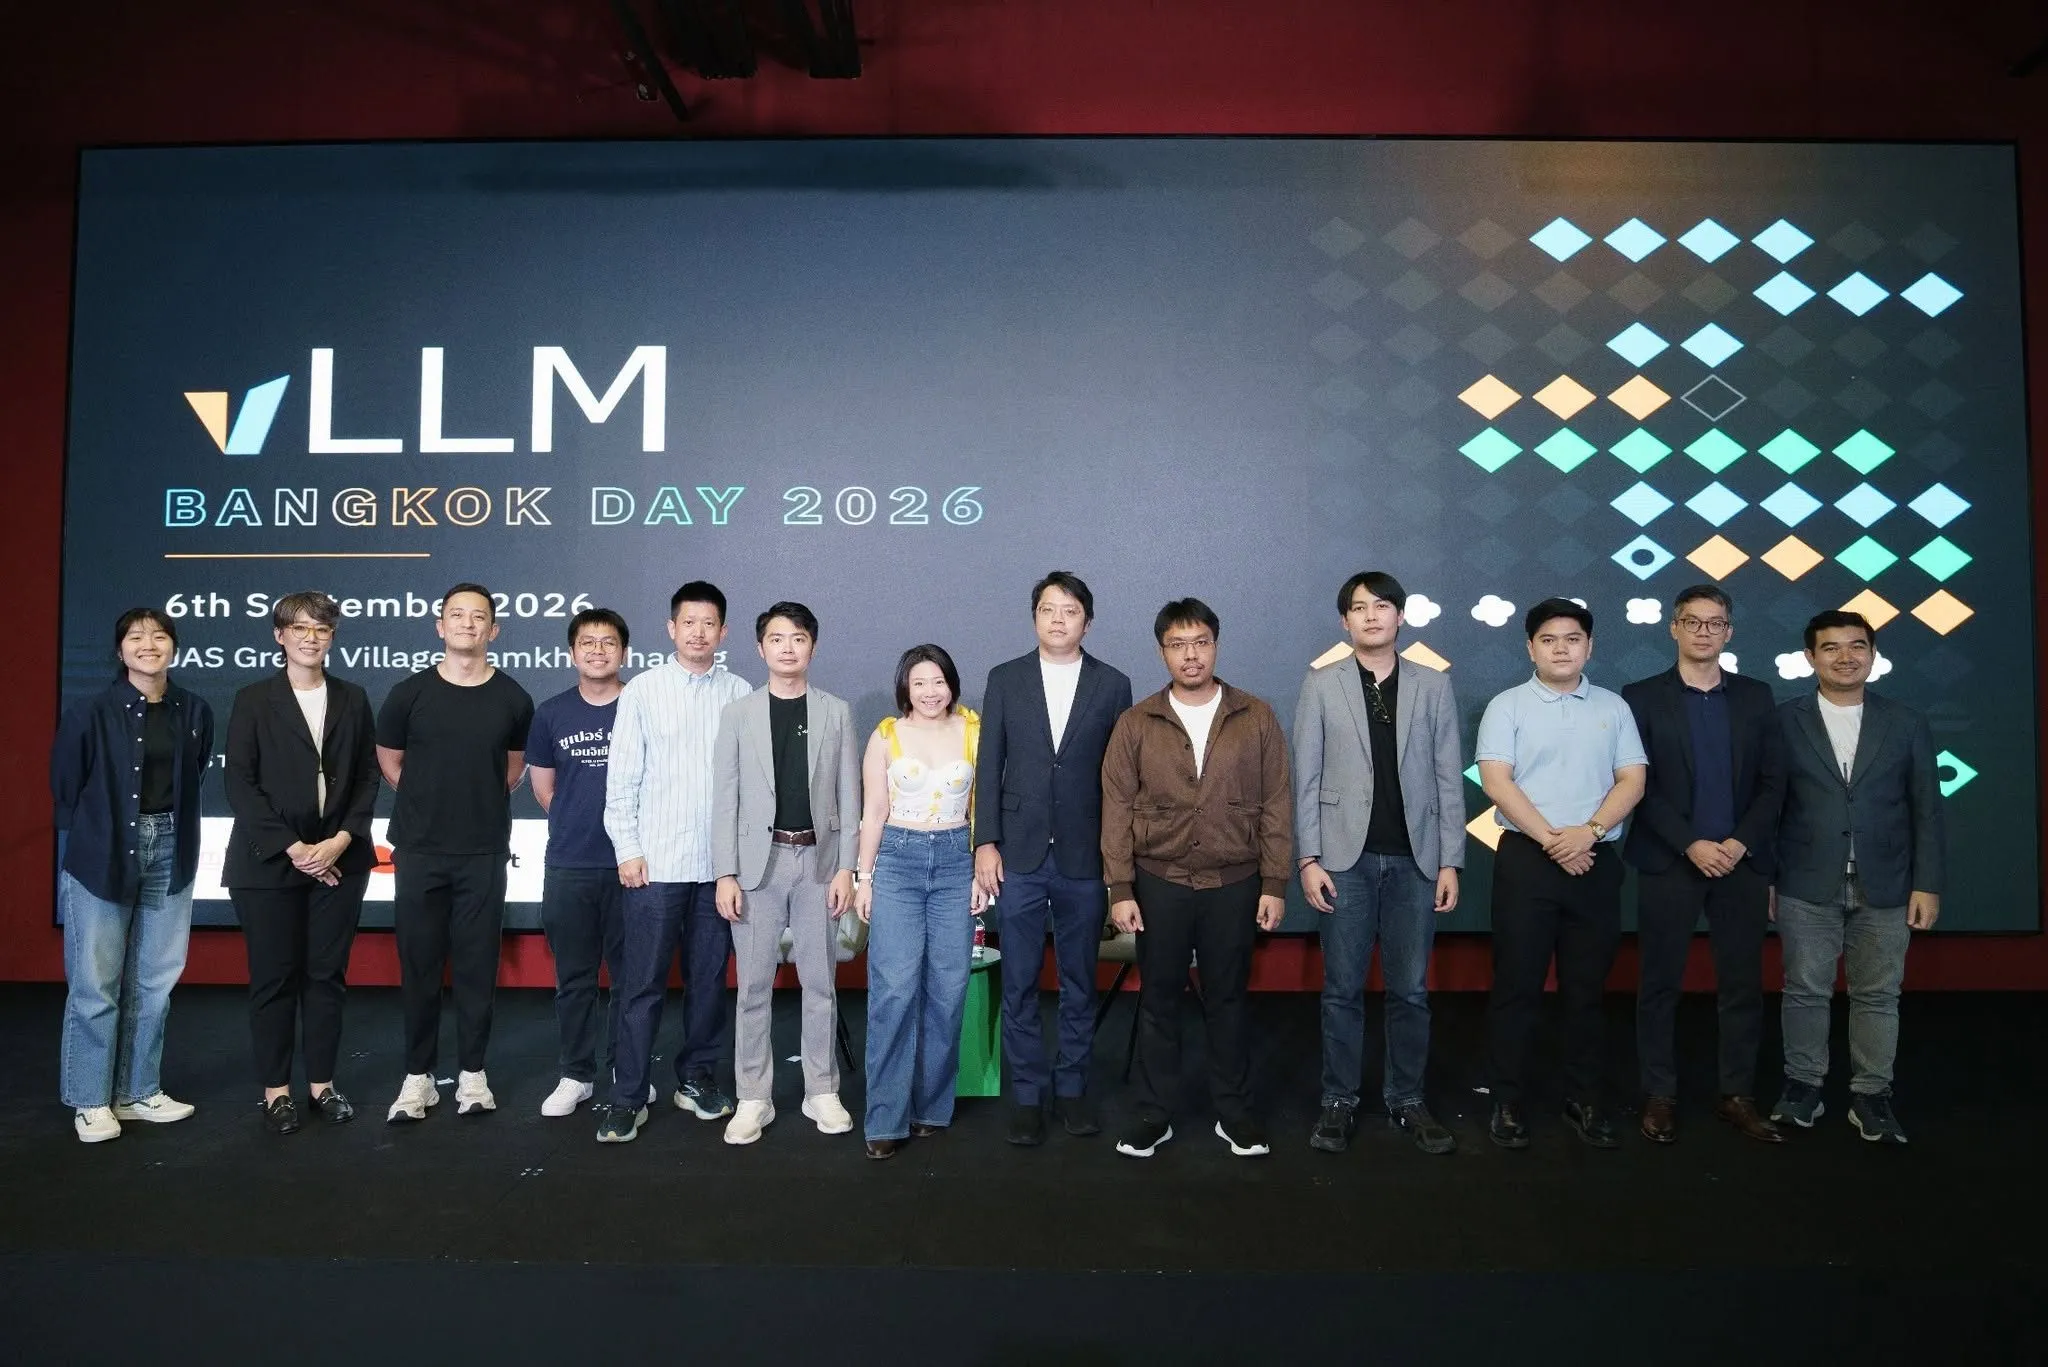
  • สปีกเกอร์และทีมผู้จัดถ่ายภาพร่วมกันบนเวที หน้าจอ LED vLLM Bangkok Day 2026

    จัดไปแล้วงานหลักของเรา

    · 14:00–19:00 · แจส กรีน วิลเลจ รามคำแหง

    vLLM Bangkok Day

    งานหลักของเราที่ JAS Green Village: บรรยายจาก maintainer ของ vLLM เคสโปรดักชันจากทีมไทย สองเสวนา กับผู้เข้าร่วมเต็มห้อง — บันทึกวิดีโอ สไลด์ และภาพบรรยากาศอยู่ที่หน้าย้อนหลัง

    วิดีโอ สไลด์ และภาพบรรยากาศ →5 ชุดสไลด์
  • สไลด์เปิดงาน Pie & AI: a sweet meetup for deep learners โดย DeepLearning.AI

    จัดไปแล้วจัดโดยคอมมูนิตี้ของเรา

    · 13:00–18:00 · Cleverse พระราม 9

    Pie & AI Bangkok 2026

    meetup คอมมูนิตี้ของ DeepLearning.AI จัดโดย AGICAFET

    บ่ายวันเสาร์ว่าด้วย AI บนอุปกรณ์ปลายทาง จัดโดย AGICAFET ในฐานะ meetup Pie & AI ของ DeepLearning.AI ที่ Cleverse พระราม 9 เปิดงานโดย Andrew Ng ตามด้วยเซสชัน NVIDIA Isaac กับ physical AI (AGICAFET), agentic orchestration บนฮาร์ดแวร์ในองค์กร (IBM), การนำ KV cache กลับมาใช้ซ้ำ (Tensormesh), Edge AI ในงานจริง (True Digital), Local AI สำหรับรถยนต์ไร้คนขับ (Aueaphum Aueawatthanaphisut), Mamba inference บนระบบฝังตัว (Friso Smit) และให้ vLLM เลือก skill ที่เหมาะจากคลังขนาดใหญ่ (Datakarate) ปิดท้ายด้วยเน็ตเวิร์กกิ้ง

    สไลด์และรายละเอียด →5 ชุดสไลด์

  • สไลด์หน้าแรก: Scaling Intelligence — Agentic Workflows with vLLM โดย Jun Kang Chow ที่ TechXchange 28 เมษายน 2026

    จัดไปแล้วเซสชัน vLLM ในงานของหน่วยงานอื่น

    · 15:00–19:00 · ไอบีเอ็ม ประเทศไทย (อาคาร SP)

    IBM TechXchange Thailand 2026

    The Agentic Workforce: Scaling Multi-Agent Orchestration

    งานครึ่งวันว่าด้วย multi-agent orchestration จัดโดย IBM Thailand ร่วมกับ AI Alliance ที่อาคาร SP มีผู้บรรยายจาก KBTG, ETDA และ AI Governance Clinic, SCG Digital, CJ More, EGG Digital, NECTEC, IBM และ Embedded LLM พร้อมเสวนาเรื่องกรอบ Responsible AI และความปลอดภัยระดับองค์กร โดย Embedded LLM รับหน้าที่เซสชัน vLLM

    สไลด์และรายละเอียด →1 ชุดสไลด์

ติดตามข่าวสาร

อีเมลหนึ่งฉบับเมื่อประกาศงานถัดไปหรือเปิดลงทะเบียน พร้อมข่าวเป็นครั้งคราวว่าคอมมูนิตี้ vLLM ไทยกำลังสร้างอะไร ไม่มีสแปม ยกเลิกได้ทุกเมื่อ