6 นาที★

vLLM Bangkok Day: ผู้สร้าง vLLM กำลังจะมากรุงเทพฯ

วันที่ 6 กันยายน 2569 ทีมผู้สร้าง vLLM จะมากรุงเทพฯ พร้อมกับหนึ่งบ่ายเต็มของ การพูดคุยเรื่อง inference บนงานจริง เคสจากทีมไทย และการพบปะสร้างเครือข่าย เข้าร่วมฟรี — นี่คือสิ่งที่จะได้เจอ

  • งานอีเวนต์
  • คอมมูนิตี้
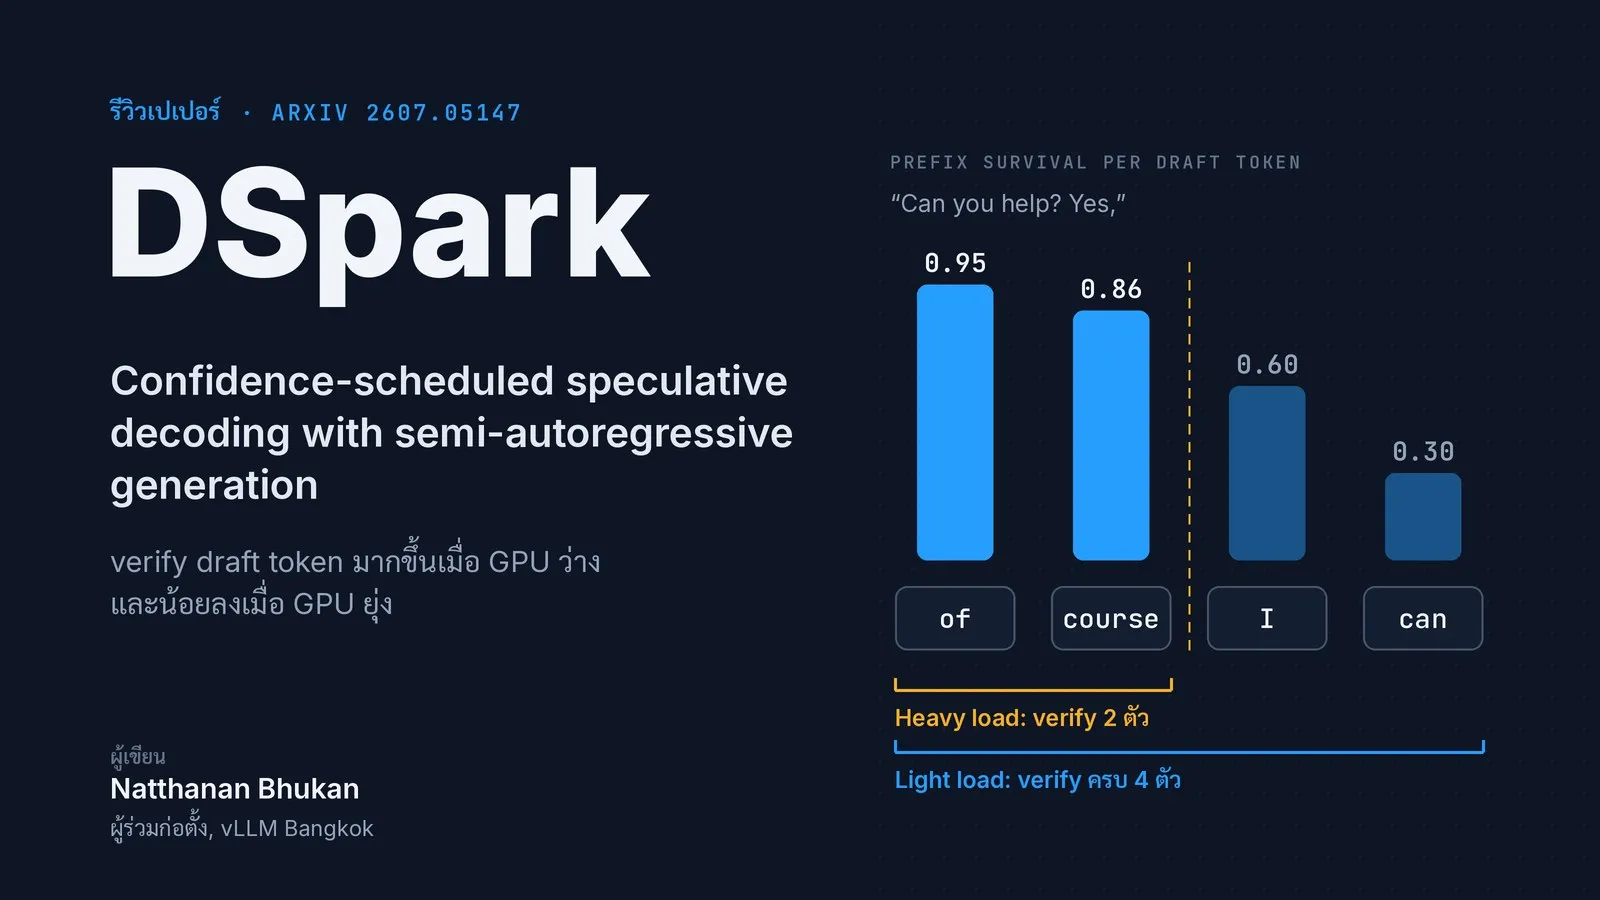
ภาพปกรีวิวเปเปอร์ DSpark พร้อมกราฟแท่ง prefix survival ของ draft token of, course, I และ can ที่ 0.95, 0.86, 0.60 และ 0.30 โดยที่ heavy load จะ verify สอง token แรก และที่ light load จะ verify ครบทั้งสี่ตัว
53 นาที

รีวิวเปเปอร์ DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation

รีวิวเปเปอร์ว่า DSpark ช่วยให้ speculative decoding ดีขึ้นได้อย่างไร ในบทความนี้เราจะพาไปดูว่า DSpark ออกแบบมาอย่างไร และทำไมถึงเพิ่ม throughput ได้ด้วย accepted length ที่สูงขึ้น

  • vllm
  • inference
  • speculative-decoding
สไลด์แรกของเด็คสรุปภาษาไทย: ชื่อทอล์ก Serving the Agentic Workload บนพื้นสีกรมท่าเข้มลายตารางพิกเซล ผู้บรรยาย Simon Mo
40 นาที

สรุปทอล์ก Serving the Agentic Workload ของ Simon Mo: งาน AI agent เปลี่ยนการ serve โมเดลอย่างไร

สรุปภาษาไทยจากทอล์กของ Simon Mo (Inferact) ที่ Runtime 2026 ว่าทำไมงาน AI agent ที่อ่าน context ยาวแต่ตอบสั้นทำให้ KV cache กลายเป็นหัวใจของการ serve โมเดล ทีม vLLM แก้อย่างไร และ hardware หลายค่ายเข้ามาเกี่ยวตรงไหน พร้อมสไลด์และแหล่งอ้างอิง

  • vllm
  • inference
  • agent
9 นาที

vLLM คืออะไร และทำไม throughput ถึงกระโดดเมื่อย้ายมาใช้

ปูพื้นแบบใช้งานได้จริงกับสองแนวคิดที่ทำให้ vLLM เร็ว — PagedAttention และ continuous batching — และมันหมายความว่าอย่างไรกับบิลค่า GPU ของทีมไทย ที่เสิร์ฟโมเดล open-weights

  • vllm
  • inference
  • พื้นฐาน

ติดตามข่าวสาร

อีเมลหนึ่งฉบับเมื่อประกาศงานถัดไปหรือเปิดลงทะเบียน พร้อมข่าวเป็นครั้งคราวว่าคอมมูนิตี้ vLLM ไทยกำลังสร้างอะไร ไม่มีสแปม ยกเลิกได้ทุกเมื่อ